
Die Datenanalyse ist der Arbeitsschritt, in dem aus deinen erhobenen Rohdaten verwertbare Erkenntnisse werden. Du bereinigst die Daten, wählst passende Analysemethoden, wertest systematisch aus und stellst die Ergebnisse in Tabellen und Diagrammen dar. Der konkrete Ablauf hängt davon ab, ob du quantitativ mit Zahlen oder qualitativ mit Texten arbeitest.
Lege Auswertungsverfahren und Ausschlussregeln möglichst vor dem Blick auf die Ergebnisse fest. So trennst du begründete Analyseentscheidungen von nachträglicher Ergebnisoptimierung und schaffst eine saubere Grundlage für den Ergebnisteil.
Datenanalyse in vier Schritten
-
Daten bereinigen (Ausreißer, fehlende Werte dokumentieren)
-
Analysemethode passend zur Forschungsfrage wählen
-
Auswertung durchführen und Voraussetzungen prüfen
-
Ergebnisse mit Tabellen, Diagrammen und Fließtext darstellen
Hinweis zu Vorgaben: Die Vorgaben variieren je nach Fachbereich und Lehrstuhl, deshalb solltest du frühzeitig mit deiner Betreuung klären, welche Verfahren und welche Software erwartet werden.
Inhaltsverzeichnis
Was ist Datenanalyse in der Bachelorarbeit?
In der Datenanalyse wertest du das Material aus, das du durch Umfragen, Interviews, Experimente oder andere Erhebungsmethoden gesammelt hast. Das Ziel ist, Muster zu erkennen, Zusammenhänge zu prüfen und deine Forschungsfrage zu beantworten. Anders als beim bloßen Zusammenfassen geht es darum, deine Hypothesen systematisch zu testen oder aus dem Material neue Erkenntnisse zu gewinnen.
Der Ablauf hängt davon ab, ob du quantitativ oder qualitativ arbeitest. Bei quantitativen Studien rechnest du mit Zahlen und statistischen Verfahren: Du testest, ob Unterschiede zwischen Gruppen signifikant sind oder ob Variablen zusammenhängen. Bei qualitativen Studien analysierst du Texte, Aussagen oder Beobachtungen auf inhaltliche Muster: Du kodierst Passagen, bildest Kategorien und arbeitest zentrale Themen heraus. Manche Arbeiten kombinieren beide Ansätze im Mixed-Methods-Design.
Die Datenanalyse bildet das Herzstück deines empirischen Teils. Ohne saubere Auswertung bleiben deine Daten nur Rohmaterial. Erst durch die Analyse entstehen Erkenntnisse, die du in der Diskussion interpretieren und in den Forschungsstand einordnen kannst.
Zeitplanung: Wie lange dauert die Datenanalyse?
Die Dauer der Datenanalyse variiert stark je nach Methode, Datenumfang und deiner Vorerfahrung mit der Software. Pauschale Wochenangaben aus anderen Arbeiten helfen dir deshalb wenig. Schätze die einzelnen Arbeitsschritte stattdessen mit Testdaten oder einer repräsentativen Teilmenge.
Bei einer quantitativen Studie kannst du den vollständigen Ablauf mit Testdaten vorbereiten: Import, Plausibilitätsprüfungen, Bereinigung, deskriptive Auswertung, Modellschätzung, Diagnostik sowie die Ausgabe von Tabellen und Diagrammen. Miss den Aufwand an einer repräsentativen Teilmenge und plane Korrekturschleifen für unerwartete Datenprobleme oder eine begründete Änderung des Verfahrens ein.
Bei einer qualitativen Studie mit Interviews kann eine Stunde Aufnahme je nach Transkriptionsregeln, Audioqualität und Erfahrung ungefähr 3 bis 10 Stunden manuelle Transkription erfordern. Ermittle deinen eigenen Faktor mit einer kurzen Probe. Den Aufwand für Datenschutzprüfung und Kodierung schätzt du anschließend getrennt, weil er nicht automatisch der Transkriptionszeit entspricht.
Beispiel: Benötigst du für 15 Minuten Aufnahme einschließlich Kontrolle 90 Minuten, entspricht das 6 Stunden pro Aufnahmestunde. Zehn Interviews à 45 Minuten ergeben 7,5 Aufnahmestunden und damit etwa 45 Stunden für diesen Transkriptionsschritt.
Prüfe danach an einem möglichst repräsentativen Interview separat, wie viel Zeit Datenschutzprüfung und Kodierung beanspruchen. Ergänze auf Basis dieser Messungen einen realistischen Puffer.
Vorbereitung: Daten bereinigen und strukturieren
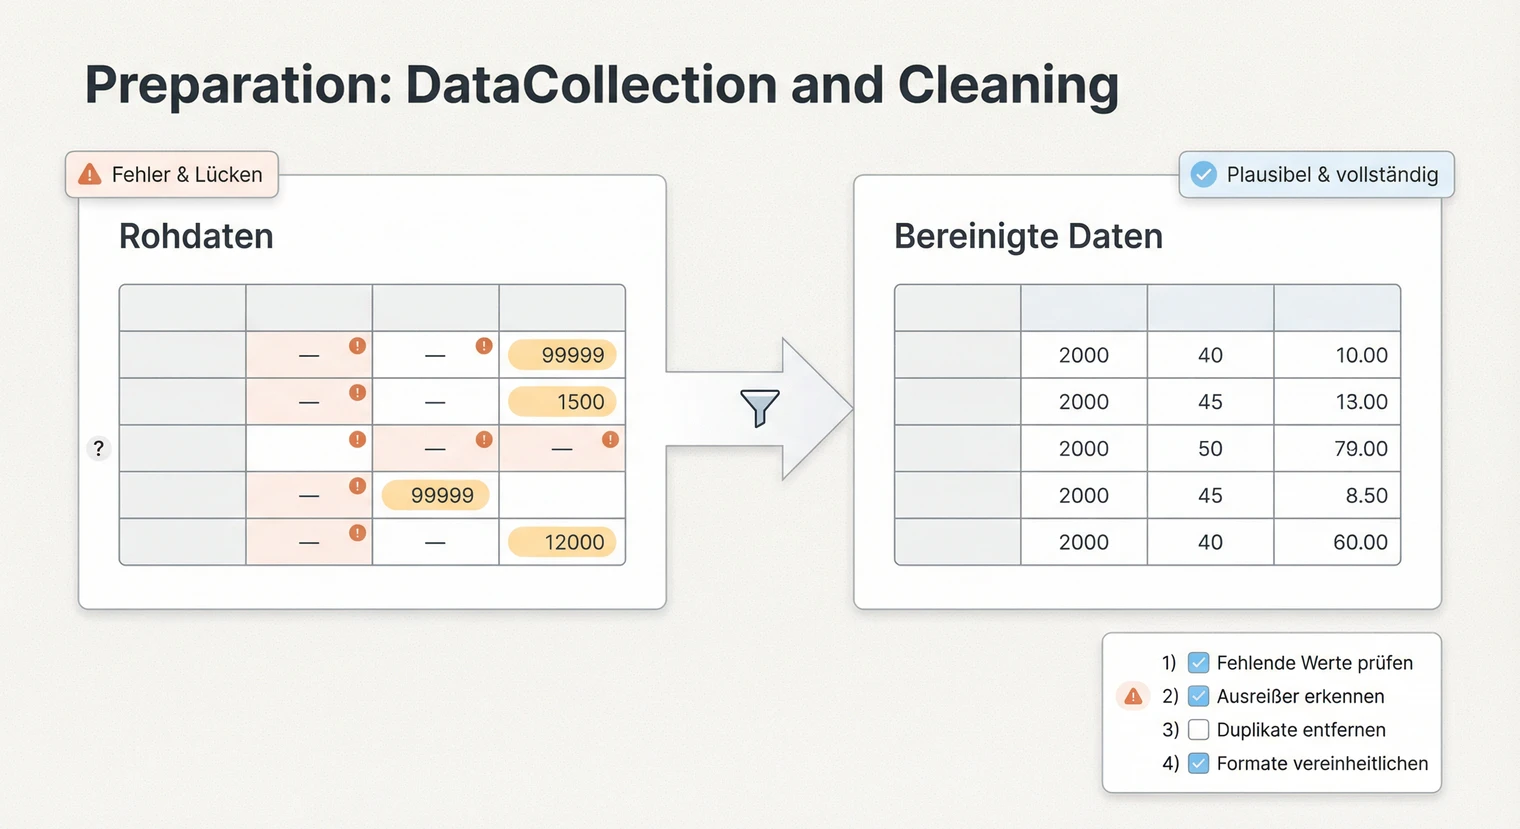
Bevor du mit der eigentlichen Analyse beginnst, müssen deine Daten geprüft und nachvollziehbar aufbereitet sein. Dieser Schritt wird oft unterschätzt, ist aber entscheidend für die Qualität deiner Ergebnisse. Fehler in der Datenbereinigung pflanzen sich durch alle weiteren Analysen fort.
Bei quantitativen Daten prüfst du zunächst die Vollständigkeit. Fehlen Antworten bei einzelnen Fragen? Gibt es unplausible Werte, etwa ein Alter von 200 Jahren oder negative Werte bei einer Skala, die nur positive Werte erlaubt? Solche Fälle dokumentierst du in einer Bereinigungstabelle: Wie viele Datensätze sind betroffen? Was ist das Problem? Wie hast du entschieden?
Fehlende Werte erfordern eine bewusste Entscheidung. Ermittle zuerst Umfang und Muster der fehlenden Angaben sowie plausible Gründe für das Fehlen. Das pauschale Ersetzen durch den Mittelwert ist für inferenzstatistische Analysen keine neutrale Lösung: Es verringert künstlich die Streuung und kann Zusammenhänge verzerren.
Beim vollständigen Fallausschluss (Listwise Deletion) basiert die Analyse nur auf vollständigen Fällen; das ist nur unter passenden Annahmen unverzerrt und reduziert die effektive Stichprobe. Der paarweise Ausschluss (Pairwise Deletion) nutzt je Kennwert andere verfügbare Fälle, kann dadurch aber wechselnde Nenner und eine inkonsistente Korrelations- oder Kovarianzmatrix erzeugen.
Bei einer Multiplen Imputation müssen Imputationsmodell und Annahmen zur Fragestellung passen; Schätzwerte und Standardfehler werden anschließend regelgerecht über die imputierten Datensätze gepoolt. Dokumentiere die Fallzahl jeder Analyse, begründe deine Strategie im Methodenteil und prüfe wichtige Entscheidungen möglichst mit einer Sensitivitätsanalyse.
Wenn du aufgezeichnete Interviews oder Fokusgruppen transkriptbasiert auswertest, steht zunächst die Transkription an. Je nach Material, Forschungsfrage und gewählter Methode kann die Auswertung auch direkt am Audio-, Video- oder Bildmaterial ansetzen. Falls du transkribierst, lege vorher Transkriptionsregeln fest: Notierst du Pausen, Betonungen, Füllwörter? Je nach Forschungsfrage reicht oft eine einfache wörtliche Transkription. Kennzeichne jedes Interview eindeutig (I1, I2, ...) und nummeriere die Absätze, damit du später Zitate präzise zuordnen kannst.
Organisiere deine Dateien so, dass du jeden Schritt nachvollziehen kannst. Bewährt hat sich eine Ordnerstruktur mit:
Rohdaten (unverändert), bereinigte Daten (nach Bereinigung), Syntax-Dateien (SPSS, R) oder Kodier-Dateien (MAXQDA), Outputs (Tabellen, Diagramme).
So kannst du bei Rückfragen der Betreuung jeden Schritt belegen.
Quantitative Datenanalyse: Vorgehen und Verfahren
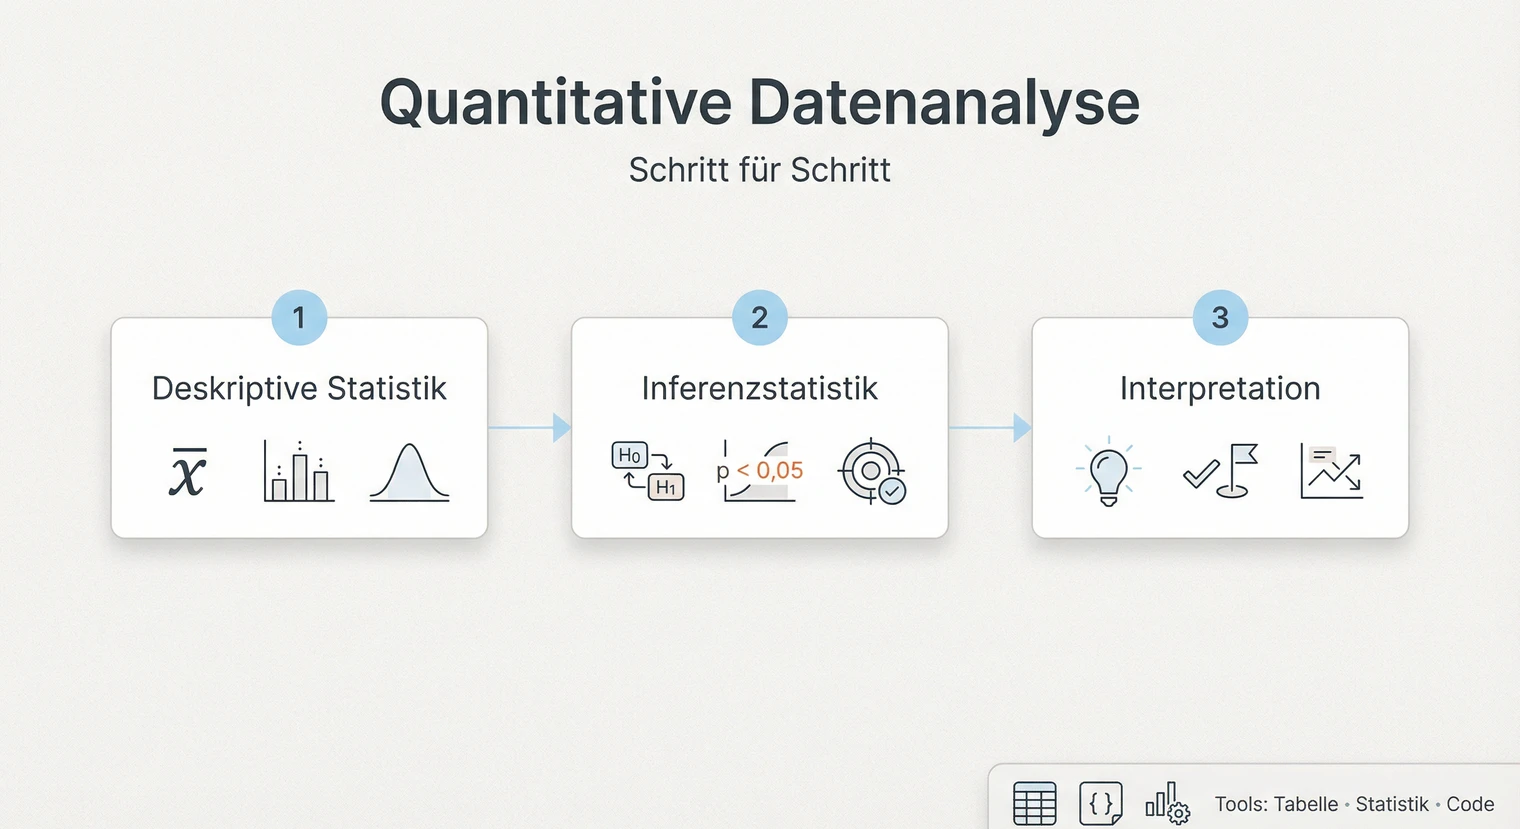
Die quantitative Analyse arbeitet mit Zahlen und statistischen Verfahren. Du beschreibst deine Stichprobe, testest Hypothesen und quantifizierst Effekte. Der zentrale Schritt ist die Wahl des richtigen Verfahrens, denn nicht jeder Test passt zu jeder Fragestellung.
Schritt 1: Deskriptive Statistik
Beginne immer mit einer Beschreibung deiner Stichprobe. Wie viele Personen haben teilgenommen? Wie verteilen sich Alter, Geschlecht oder andere relevante Merkmale? Berechne für deine zentralen Variablen Mittelwerte (M), Standardabweichungen (SD), Minimum und Maximum. Dieser Überblick zeigt, mit welchen Daten du arbeitest und ob die Stichprobe zur Zielgruppe passt.
Schritt 2: Das richtige Verfahren wählen
Die Wahl des statistischen Verfahrens hängt von Forschungsfrage, Zielgröße, Design, Abhängigkeitsstruktur, Skalenniveau und den Modellannahmen ab. Bei zwei unabhängigen Gruppen und einer metrischen Zielgröße kommt ein t-Test für unabhängige Stichproben infrage. Vergleichst du zwei Messungen derselben Personen oder fest zugeordnete Paare, analysiert ein gepaarter t-Test die Differenzen innerhalb der Paare. Wiederholte Messungen oder geclusterte Beobachtungen benötigen Verfahren, die diese Abhängigkeit abbilden. Bei mehr als zwei Gruppen kann je nach Design ein Modell aus der ANOVA-Familie passen.
Die Pearson-Korrelation beschreibt einen linearen Zusammenhang zwischen zwei quantitativen Variablen. Die Spearman-Korrelation arbeitet mit Rängen und beschreibt einen monotonen Zusammenhang; sie kann etwa für ordinale Daten geeignet sein. Für eine metrische Zielgröße kann eine lineare Regression Zusammenhänge schätzen oder Vorhersagen bilden, für eine binäre Zielgröße kommt eine logistische Regression infrage. Sprich ohne geeignetes kausales Design und die dafür nötigen Annahmen von Zusammenhang oder Vorhersage, nicht von Einfluss oder Wirkung.
-
Mittelwertsunterschied zwischen zwei Gruppen oder Messzeitpunkten?
t-Test für unabhängige oder gepaarte Stichproben prüfen
-
Mehrere Gruppen oder Messzeitpunkte?
ANOVA-Modell oder anderes designgerechtes Modell prüfen
-
Linearer oder monotoner Zusammenhang?
Pearson- oder Spearman-Korrelation prüfen
-
Metrische Zielgröße erklären oder vorhersagen?
lineare Regression prüfen
-
Binäre Zielgröße vorhersagen?
logistische Regression prüfen
Schritt 3: Voraussetzungen prüfen
Prüfe die Voraussetzungen des gewählten statistischen Modells. Die Unabhängigkeitsstruktur wird vor allem durch das Studiendesign bestimmt. Beim gepaarten t-Test betrifft die Normalitätsannahme die Differenzen innerhalb der Paare. Bei klassischen linearen Gruppenmodellen und linearen Regressionen bezieht sie sich auf die Fehler; zur Diagnose betrachtest du die Residuen. Prüfe bei linearen Regressionen außerdem Linearität, Homoskedastizität, einflussreiche Fälle (z. B. Cook's Distance) und problematische Abhängigkeiten zwischen Prädiktoren. VIF-Werte über 10 werden häufig als Warnsignal verwendet, sind aber keine automatischen Ausschlusskriterien. Beurteile sie zusammen mit Design, Koeffizienten, Standardfehlern und weiteren Diagnosen.
Formale Normalitätstests können bei großen Stichproben auch kleine Abweichungen erkennen und haben bei kleinen Stichproben nur begrenzte Aussagekraft. Kombiniere sie deshalb, wenn sie für dein Verfahren vorgesehen sind, mit Histogrammen, Q-Q-Plots und Residualdiagnostik. Eine verletzte Annahme führt nicht automatisch zu einer bestimmten Alternative. Je nach Zielgröße, Design und Art der Abweichung können ein robustes Verfahren, ein angepasstes Modell, ein Rangverfahren oder eine begründete Transformation passen. Bei ungleichen Varianzen zweier unabhängiger Gruppen kommt etwa der Welch-t-Test infrage. Für geeignete Rangvergleiche zwischen zwei unabhängigen Gruppen kann der Mann-Whitney-U-Test passen; er prüft eine andere Fragestellung als ein Vergleich von Mittelwerten. Dokumentiere, was du geprüft und warum du dich für die gewählte Lösung entschieden hast.
Schritt 4: Ergebnisse berichten
t-Test, zwei unabhängige Gruppen mit je n = 50 und angenommener Varianzhomogenität: „Die Experimentalgruppe (M = 4.2, SD = 0.8) unterschied sich von der Kontrollgruppe (M = 3.5, SD = 0.9), mittlere Differenz = 0.70, 95%-KI [0.36, 1.04], t(98) = 4.11, p < .001, d = 0.82.“
Korrelation, n = 100: „Es zeigte sich ein positiver Zusammenhang zwischen Arbeitszufriedenheit und Commitment, r(98) = .45, p < .001, 95%-KI [.28, .59].“
Regression, n = 100: „Das Modell erklärte 34% der Varianz in der Arbeitszufriedenheit, F(3, 96) = 16.48, p < .001, R² = .34. Für Autonomie wurde β = .42, SE = .09, 95%-KI [.24, .60], p < .001 geschätzt.“
Die Zahlen sind fiktiv. Übernimm die passende Satzstruktur und setze deine eigenen Ergebnisse ein. Die Effektstärke variiert je nach Verfahren (d bei t-Tests, η² bei ANOVA, Odds Ratio bei logistischer Regression). Passe auch die Formatierung an die Vorgaben deines Fachbereichs an.
Software für quantitative Analysen: SPSS ist an vielen Hochschulen Standard und bietet eine grafische Oberfläche. R ist kostenlos und flexibler, erfordert aber Einarbeitung in die Programmiersprache. Für einfache Auswertungen wie deskriptive Statistiken und t-Tests reicht oft Excel. Frag deine Betreuung, welche Tools empfohlen werden und ob dein Fachbereich Lizenzen bereitstellt.
Qualitative Datenanalyse: Kodieren und Kategorisieren
Die qualitative Analyse arbeitet mit Texten, Interviews oder Beobachtungen. Du suchst nach Mustern, Themen und Bedeutungen. Das Vorgehen ist systematischer als oft angenommen und folgt klaren Schritten.
Vereinfachter Ablauf einer qualitativen Inhaltsanalyse
Die qualitative Inhaltsanalyse nach Mayring umfasst unterschiedliche Varianten, etwa induktive Kategorienbildung und deduktive Kategorienanwendung. Benenne und begründe deshalb die Variante, die du tatsächlich verwendest. Ein vereinfachter Ablauf sieht so aus:
- Forschungsfrage, Material und Analyseeinheiten festlegen.
- Je nach Variante Auswahlkriterium und Abstraktionsniveau oder ein theoriegeleitetes Kategoriensystem mit Definitionen, Ankerbeispielen und Kodierregeln festlegen.
- Relevante Passagen zunächst markieren oder direkt am Material kodieren.
- Das System an einem ausreichend vielfältigen Teil des Materials erproben und überarbeiten.
- Das gesamte Material mit den finalen Regeln kodieren.
- Die Kategorien im Hinblick auf die Forschungsfrage interpretieren.
Häufigkeiten wertest du nur aus, wenn sie für deine Fragestellung und gewählte Variante sinnvoll sind.
Interviewaussage (I3, Abs. 24): „Am Anfang war ich total überfordert mit der ganzen Technik. Aber nach zwei Wochen ging das dann.“
Code: „Anfängliche technische Überforderung“ + „Gewöhnungseffekt“
Kategorie: „Einarbeitungsphase“ (zusammen mit ähnlichen Codes wie „Lernkurve“, „Anfangsschwierigkeiten“)
Ergebnis-Satz: „Die Kategorie ‚Einarbeitungsphase‘ wurde in 8 von 10 Interviews kodiert. I3 beschrieb anfängliche technische Überforderung und einen routinierteren Umgang nach etwa zwei Wochen.“
Deduktiv oder induktiv? Bei der deduktiven Vorgehensweise leitest du Kategorien vorab aus der Theorie ab und wendest sie regelgeleitet auf das Material an. Bei der induktiven Vorgehensweise entwickelst du Kategorien anhand eines vorab festgelegten Auswahlkriteriums und Abstraktionsniveaus aus dem Material. Du kannst beide Ansätze kombinieren, wenn du dieses Vorgehen methodisch begründest und dokumentierst.
Qualitätssicherung beim Kodieren: Für die Erprobung des Kategoriensystems kannst du bei zehn Interviews zum Beispiel mit zwei bis drei möglichst unterschiedlichen Interviews starten. Ob dieser Umfang genügt, hängt von Korpus, Variante und Stabilität des Systems ab. Das Codebuch dokumentiert jede Kategorie mit Definition, Ankerbeispiel und Abgrenzungsregeln. Wenn deine gewählte Methode und dein Forschungsdesign eine Übereinstimmungsprüfung vorsehen, kann eine zweite Person einen Teil des Materials kodieren und ihr könnt die Zuordnungen vergleichen. Im Ergebnisteil belegst du deine Kategorien mit prägnanten Originalzitaten und gibst die Quelle an (z. B. I3, Abs. 24).
Datenschutz bei Zitaten: Prüfe, wer die Zitate erhalten soll und welche Einwilligung oder sonstige Rechtsgrundlage nach Art. 6 DSGVO die Verwendung erlaubt. Bei besonderen Kategorien personenbezogener Daten ist zusätzlich Art. 9 DSGVO zu beachten. Entferne, verallgemeinere oder kürze identifizierende Details so, dass Personen mit Mitteln, die vernünftigerweise eingesetzt werden könnten, nicht oder nicht mehr identifizierbar sind. Codes allein anonymisieren Daten nicht; pseudonymisierte Daten bleiben personenbezogen.
Software für qualitative Analysen: MAXQDA und ATLAS.ti sind spezialisierte Programme, die das Kodieren, Sortieren und Visualisieren erleichtern. Sie bieten Funktionen wie automatische Häufigkeitszählungen, Code-Kookkurrenz-Analysen und Export-Optionen für Tabellen. Für kleinere Projekte mit wenigen Interviews funktioniert auch eine strukturierte Tabelle in Word oder Excel, in der du Textstellen, Codes und Kategorien zuordnest.
Führe ein Forschungstagebuch während der Analyse. Notiere Entscheidungen (warum hast du zwei Codes zusammengelegt?), Zweifel (passt diese Aussage wirklich in die Kategorie?) und Einsichten (was fällt auf?). Das hilft dir, dein Vorgehen im Methodenteil nachvollziehbar zu beschreiben und zeigt methodische Reflexion.
Ergebnisse darstellen: Tabellen, Diagramme, Text
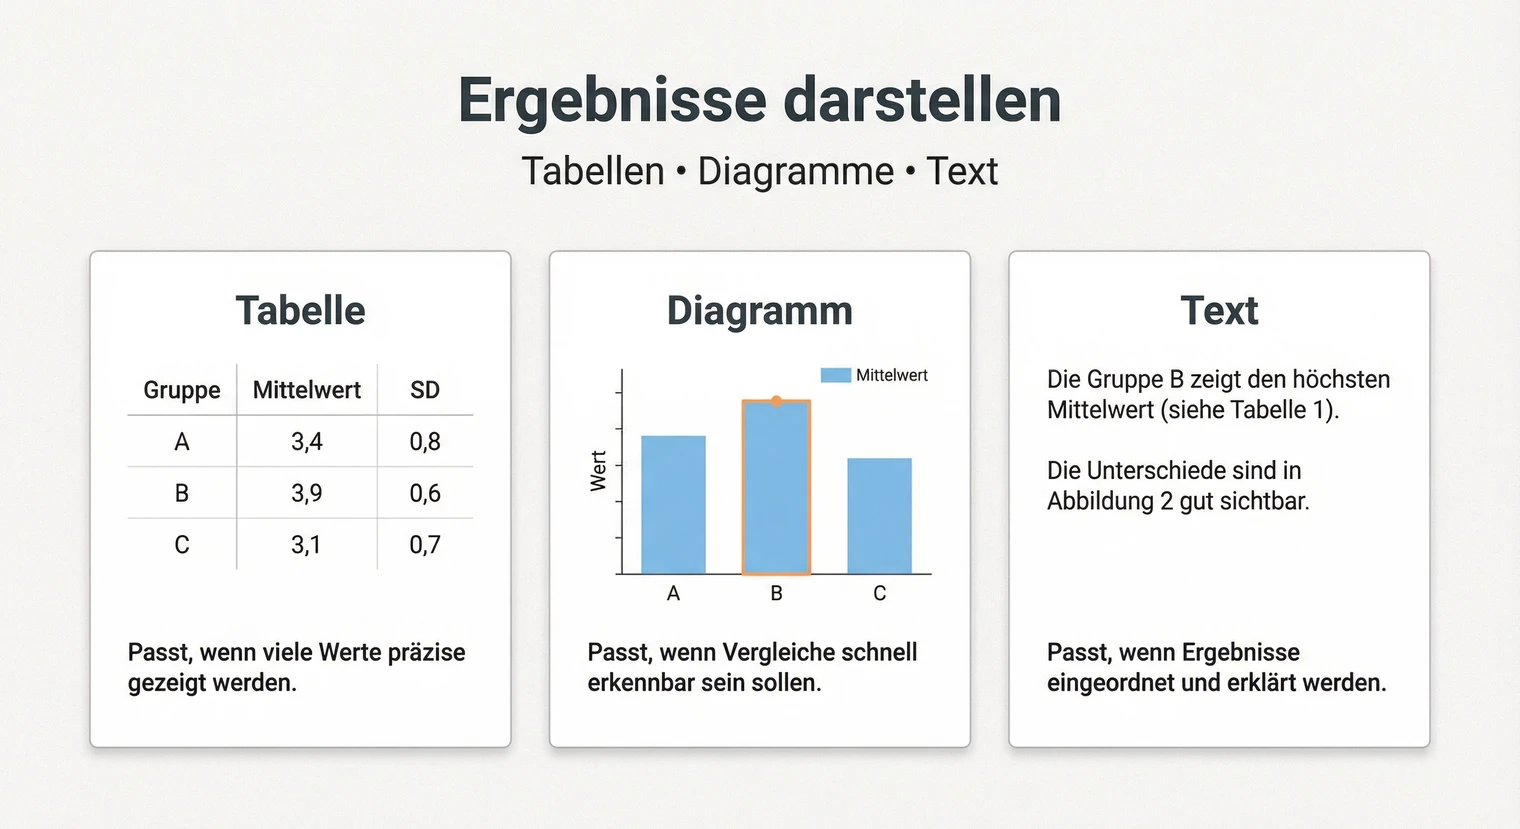
Die Darstellung deiner Ergebnisse entscheidet darüber, ob Lesende deine Analyse nachvollziehen können. Die Grundregel lautet: Im Text beschreibst du die wichtigsten Befunde in Worten, in Tabellen zeigst du präzise Zahlen, in Diagrammen visualisierst du Muster und Verteilungen.
Tabellen richtig aufbauen
Tabellen eignen sich für präzise Zahlen, die Lesende nachschlagen wollen. Eine typische deskriptive Tabelle hat die Spalten Variable, n, M (Mittelwert), SD (Standardabweichung). Eine Inferenzstatistik-Tabelle enthält zusätzlich Testkennwerte, df, p und Effektstärke. Nummeriere jede Tabelle (Tabelle 1, Tabelle 2, ...) und gib ihr einen aussagekräftigen Titel über der Tabelle. Der Titel sollte so präzise sein, dass die Tabelle auch ohne den umgebenden Text verständlich ist.
Was gehört in den Text, was in die Tabelle?
Im Fließtext beschreibst du die zentralen Befunde und ihre Bedeutung für deine Forschungsfrage. Du nennst die wichtigsten Zahlen (etwa den Mittelwertsunterschied und den p-Wert), aber du wiederholst nicht alle Werte aus der Tabelle. Ein gutes Vorgehen: Beschreibe das Ergebnis in einem Satz, verweise auf die Tabelle für Details.
Beispiel: „Die Experimentalgruppe zeigte signifikant höhere Werte als die Kontrollgruppe (siehe Tabelle 3 für deskriptive Statistiken und Testergebnisse).“
Diagramme gezielt einsetzen
Diagramme machen Verteilungen und Trends sichtbar. Balkendiagramme eignen sich für Häufigkeiten und Gruppenvergleiche, Liniendiagramme für Verläufe über Zeit, Streudiagramme für Zusammenhänge zwischen Variablen. Achte auf beschriftete Achsen mit Einheit, eine verständliche Legende und einen eindeutigen Titel an der vom Zitierstil vorgesehenen Position.
Achte darauf: Verzichte auf 3D-Effekte, Schattierungen und unnötige Farben, sie erschweren das Ablesen.
Dein Zitierstil gibt oft vor, wie Tabellen und Abbildungen formatiert werden. Nach APA 7 stehen Nummer und Titel sowohl bei Tabellen als auch bei Abbildungen darüber; Anmerkungen und Quellenangaben folgen darunter. Tabellen verwenden möglichst wenige Linien und keine vertikalen Rahmenlinien. Prüfe die Vorgaben deiner Hochschule oder deines Fachbereichs, bevor du formatierst.
Typische Fehler und wie du sie vermeidest
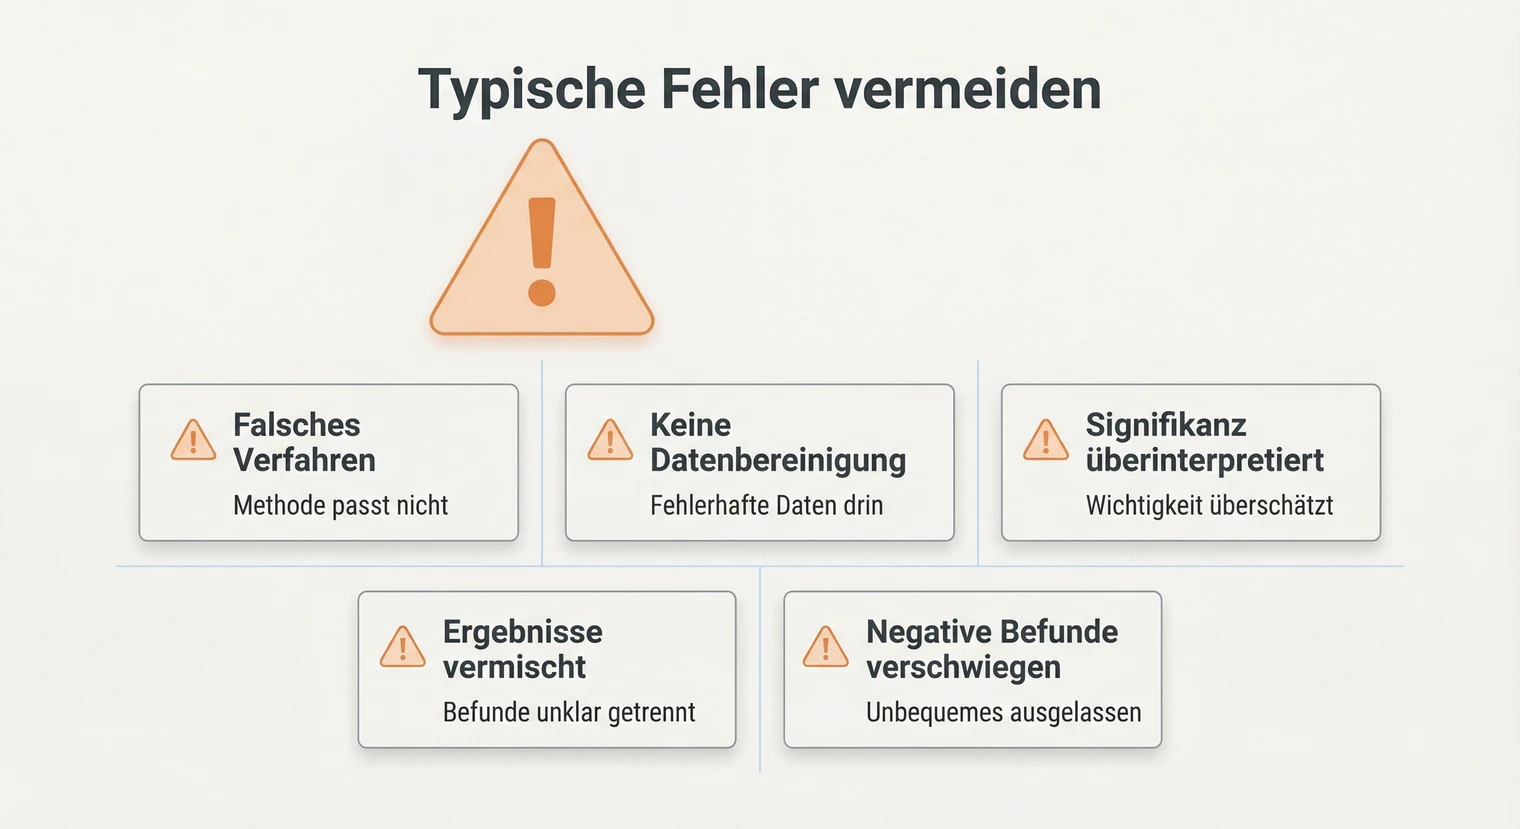
-
Falsches Verfahren wählen
Problem: Ein t-Test für abhängige Stichproben bildet unabhängige Gruppen nicht korrekt ab und kann dadurch Standardfehler und p-Werte ungültig machen.
So behebst du es: Frag dich vor jeder Analyse: Was ist meine Fragestellung (Unterschied, Zusammenhang, Vorhersage)? Wie viele Gruppen/Variablen habe ich? Welches Skalenniveau haben meine Daten? Nutze eine Entscheidungshilfe wie die Verfahrensübersicht weiter oben oder frag deine Betreuung.
-
Datenbereinigung unterschätzen
Problem: Fehlende oder fehlerhafte Daten können Schätzungen und die wirksame Stichprobengröße verändern; pauschaler Mittelwert-Ersatz ist dabei keine neutrale Lösung.
So behebst du es: Dokumentiere Bereinigung, Muster fehlender Werte, Fallzahl je Analyse und die Annahmen deiner Strategie. Führe bei wichtigen Entscheidungen eine Sensitivitätsanalyse durch: Ändert sich das Ergebnis bei einer anderen vertretbaren Behandlung der fehlenden Werte?
-
Signifikanz überinterpretieren
Problem: Ein p-Wert beschreibt, wie unverträglich die beobachteten Daten mit dem angegebenen statistischen Modell einschließlich der Nullhypothese sind. Ein Schwellenwert allein belegt weder Effektstärke noch praktische Bedeutung.
So behebst du es: Berichte immer auch die Effektstärke (Cohen's d, r, η²). Die oft zitierten Schwellen (d = 0.2 klein, d = 0.5 mittel, d = 0.8 groß) sind grobe Konventionen, keine festen Regeln. Die praktische Bedeutung hängt vom Kontext ab: In der Medizin kann ein kleiner Effekt lebensrettend sein, in anderen Bereichen irrelevant. Ordne die Effektstärke inhaltlich ein und berichte auch bei nicht signifikanten Ergebnissen Effektstärke und Konfidenzintervall.
-
Befund und Interpretation nicht unterscheiden
Problem: Auch in einem integrierten Kapitel muss erkennbar bleiben, was deine Daten zeigen und wie du diesen Befund deutest.
So behebst du es: Berichte Schätzwerte, Unsicherheit und Befunde nachvollziehbar. Ordne sie anschließend in Theorie, Forschungsstand und Limitationen ein. Ob das in getrennten oder kombinierten Kapiteln geschieht, richtet sich nach der vorgesehenen Gliederung deiner Arbeit. Fiktives Beispiel: Befund: „Gruppe B lag im Mittel 0,5 Punkte höher.“ Deutung: „Ein möglicher Grund ist die unterschiedliche Vorerfahrung.“
-
Nicht signifikante oder unerwartete Befunde verschweigen
Problem: Wenn eine Hypothese nicht bestätigt wurde oder ein Befund anders ausfällt als erwartet, ist das ebenfalls ein Ergebnis.
So behebst du es: Dokumentiere auch nicht signifikante Befunde ehrlich. Diskutiere mögliche Gründe (zu kleine Stichprobe? Messinstrument ungeeignet? Effekt existiert nicht?). Transparenz ist ein Qualitätsmerkmal wissenschaftlicher Arbeit.
Nächster Schritt: Von der Analyse zur Diskussion
Deine Datenanalyse ist abgeschlossen, wenn du alle relevanten Auswertungen durchgeführt und die Ergebnisse nachvollziehbar dargestellt hast.
-
Beantwortet die Analyse deine Forschungsfrage?
-
Sind alle Tabellen und Diagramme korrekt beschriftet?
-
Ist das Vorgehen im Methodenteil dokumentiert?
-
Sind Bereinigungsschritte und Entscheidungen nachvollziehbar?
Im nächsten Schritt interpretierst du deine Befunde in der Diskussion. Dort ordnest du die Ergebnisse in den Forschungsstand ein, diskutierst Limitationen und ziehst Schlussfolgerungen. Halte auch bei einer integrierten Darstellung erkennbar auseinander, was die Analyse zeigt und wie du den Befund im Forschungsstand interpretierst.
Sichere deine Daten und Analysedateien sorgfältig. Manche Hochschulen verlangen, dass du Rohdaten, Syntax-Dateien und Outputs im Anhang oder auf einem Datenträger einreichst. Kläre das rechtzeitig mit deiner Betreuung.
Wenn deine Arbeit fertig ist, steht der letzte Schritt an: Drucken und Binden. Achte darauf, dass du genügend Zeit für eventuelle Korrekturen einplanst, und prüfe die Druckvorschau sorgfältig. Bei empirischen Arbeiten mit umfangreichem Anhang lohnt sich eine stabile Bindung, die auch bei häufigem Blättern hält.
Häufig gestellte Fragen
Wann beginne ich mit der Datenanalyse in meiner Bachelorarbeit?
Mit der eigentlichen Auswertung beginnst du, wenn dein Datensatz geschlossen und bereinigt ist. Vorbereiten kannst du sie schon früher: Lege Auswertungsverfahren und Ausschlussregeln möglichst vor dem Blick auf die Ergebnisse fest und probiere die Arbeitsschritte mit Testdaten aus. Schätze den Aufwand für Bereinigung, Transkription und Kodierung anhand einer repräsentativen Teilmenge.
Welche Software eignet sich für die Datenanalyse?
Das hängt von deinem Forschungsansatz ab. Für quantitative Analysen sind SPSS, R oder Excel verbreitet. Für qualitative Auswertungen nutzen viele MAXQDA oder ATLAS.ti. Frag deine Betreuung, welche Tools an deiner Hochschule üblich sind und ob Lizenzen zur Verfügung stehen.
Wie gehe ich mit Ausreißern in meinen Daten um?
Prüfe zunächst, ob der Ausreißer ein Eingabefehler ist (dann korrigieren) oder ein echter, aber extremer Wert. Bei echten Ausreißern hast du mehrere Optionen: Wert beibehalten und robuste Verfahren nutzen, Wert mit Begründung ausschließen oder Wert winsorisieren (auf einen Grenzwert setzen). Dokumentiere deine Entscheidung immer im Methodenteil.
Was mache ich, wenn meine Ergebnisse nicht signifikant sind?
Nicht signifikante Ergebnisse sind keine schlechten Ergebnisse. Berichte Schätzwert, Konfidenzintervall, Test und Voraussetzungen. Diskutiere, welche Effektstärken mit den Daten noch vereinbar sind und ob Präzision, Messung oder Design die Aussage begrenzen. Ein nicht signifikanter Test beweist weder einen Nulleffekt noch automatisch zu wenig Power.
Was gehört in den Ergebnisteil und was in den Anhang?
In den Ergebnisteil gehören die zentralen Befunde sowie die Tabellen und Abbildungen, die Leser für die Aussage brauchen. Ergänzende Outputs oder Instrumente können nach Leitfaden in den Anhang. Rohdaten und Transkripte gehören nur hinein, wenn Prüfungs-, Datenschutz-, Einwilligungs- und Übermittlungsvorgaben das zulassen; pseudonymisierte Daten können weiterhin personenbezogen sein.
Wie viele Daten brauche ich für eine aussagekräftige Analyse?
Die benötigte Stichprobengröße hängt von Forschungsziel, relevanter Effektstärke oder Zielpräzision, Alpha, gewünschter Power und Design ab. Faustregeln wie „30 pro Gruppe“ oder „10 Fälle pro Prädiktor“ können zu klein oder unnötig groß sein. Qualitative Fallzahlen leitest du aus Ansatz, Sampling, Heterogenität, Informationsdichte und Auswertung ab; theoretische Sättigung passt nicht zu jedem qualitativen Design.

 Wissenschaftliche Kommunikation
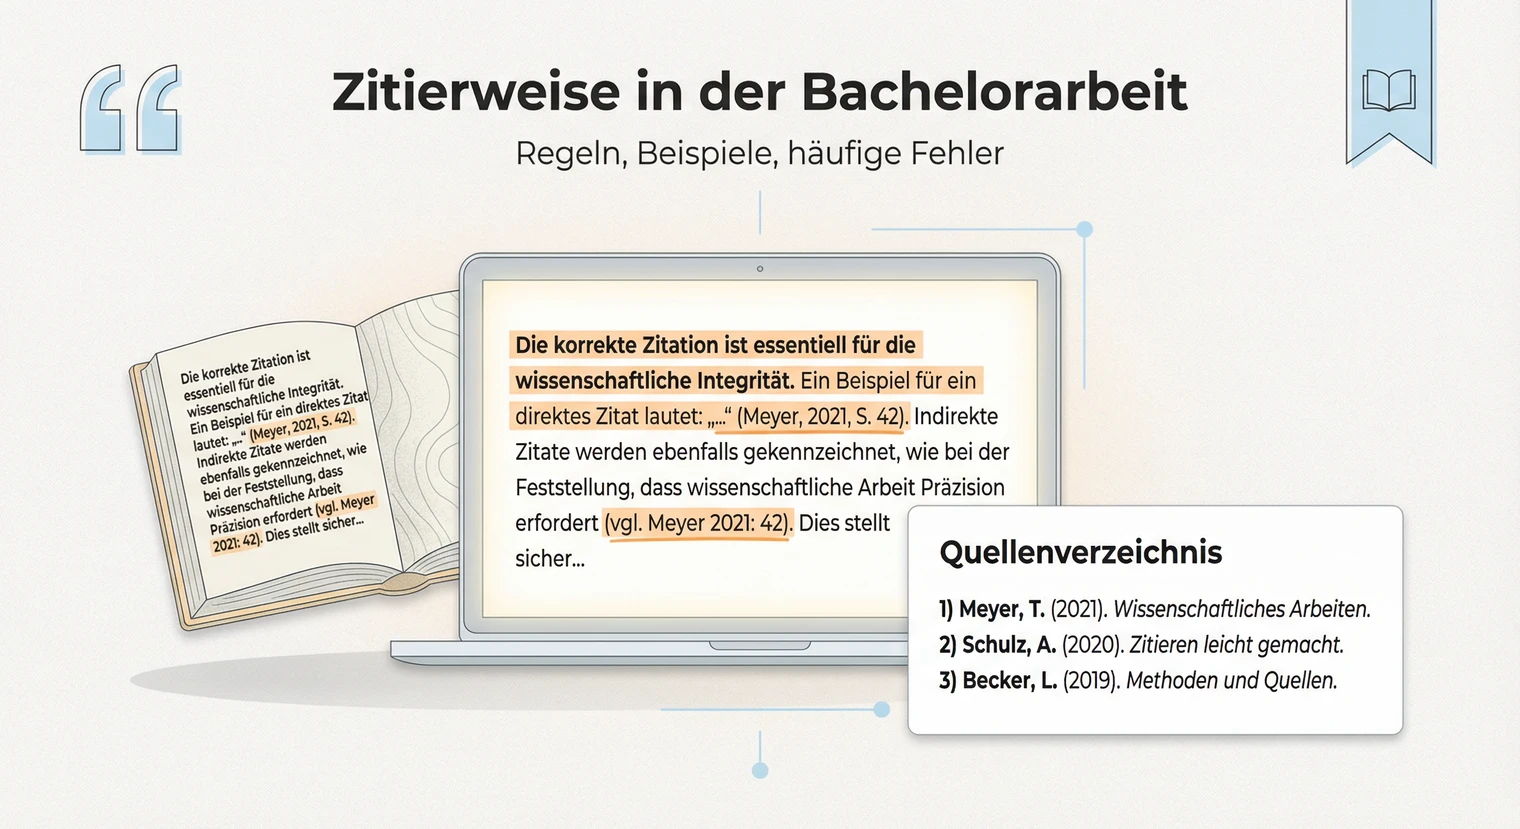 Die richtige Zitierweise
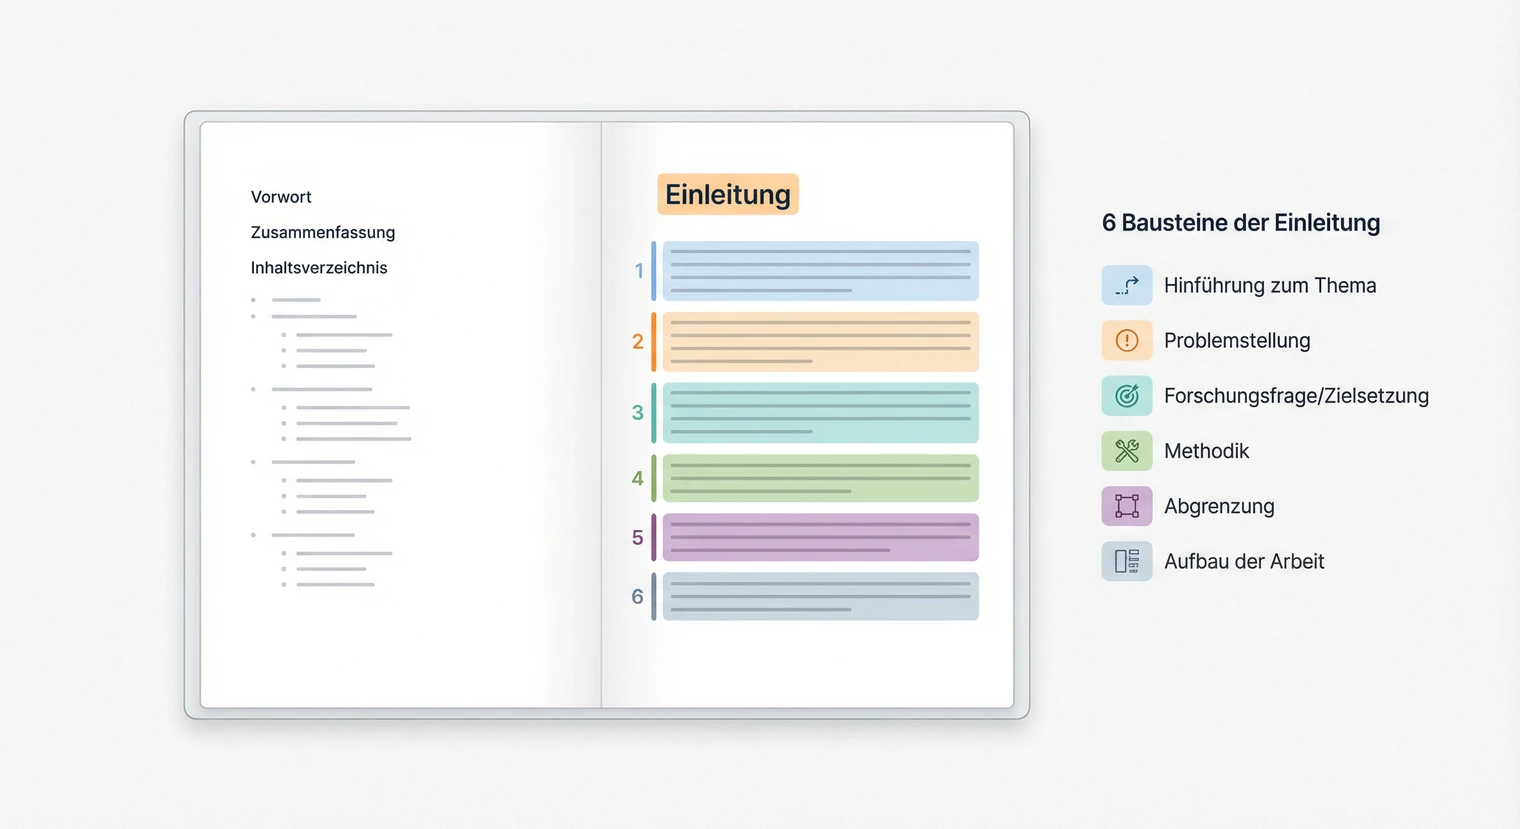 Einleitung der Bachelorarbeit