
Die Datenanalyse deiner Masterarbeit verwandelt erhobene Daten in verwertbare Erkenntnisse. Sie ist der Kern deiner empirischen Arbeit und entscheidet darüber, ob du deine Forschungsfrage beantworten kannst. Hier erfährst du, wie du systematisch vorgehst, welche Software sich eignet und welche Methoden zu deinen Daten passen. (Dieser Artikel richtet sich an empirische Masterarbeiten mit quantitativer oder qualitativer Auswertung, ob eigene Erhebung oder Sekundärdaten wie Panel-, Register- oder Open Data. Bei rein theoretischen Arbeiten entfällt die statistische Datenanalyse; dort kann aber eine systematische Literatur- oder Dokumentenanalyse relevant sein.)
Kurzantwort: Eine gute Datenanalyse beginnt mit sauberer Datenaufbereitung. Wähle dann das passende Verfahren für deine Forschungsfrage und dein Datenniveau. Dokumentiere jeden Schritt transparent, damit deine Ergebnisse nachvollziehbar sind. Plane dafür vorab ein nachvollziehbares Datenmanagement und protokolliere, wie du fehlende Werte und Bereinigungsschritte behandelst. Wenn du nur 10 Minuten hast: Schnellcheck unten → Voraussetzungen prüfen → Methode aus Matrix wählen → Abgabe-Checkliste nutzen.
-
Datentyp und Zielgröße? Geht es um Häufigkeiten, Ränge, Mittelwerte oder Zusammenhänge? Für einen linearen Zusammenhang kommt etwa Pearson infrage, für einen monotonen Rangzusammenhang Spearman. Skalenniveau allein legt das Verfahren nicht fest.
-
Forschungsfrage? Formuliere, welcher Unterschied, Zusammenhang oder Parameter geschätzt oder geprüft werden soll.
-
Design? Unterscheide unabhängige und verbundene Beobachtungen. Für zwei Messungen derselben Personen kann etwa ein gepaarter t-Test die mittlere Veränderung prüfen. Berücksichtige außerdem weitere Messzeitpunkte, Cluster und mögliche Kovariaten.
-
Modellannahmen? Prüfe die für das konkrete Verfahren relevanten Annahmen und Diagnostiken. Wähle bei Problemen eine passende robuste, modellbasierte oder rangbasierte Lösung, die dieselbe Forschungsfrage sinnvoll beantwortet.
Hinweis zu Vorgaben: Die Angaben in diesem Artikel sind Orientierungswerte. Welche Analyseverfahren und Software erwartet werden, kann je nach Studiengang und Lehrstuhl variieren. Prüfe die Richtlinien deines Fachbereichs und sprich mit deiner Betreuung.
Inhaltsverzeichnis
Der Analyseprozess im Überblick
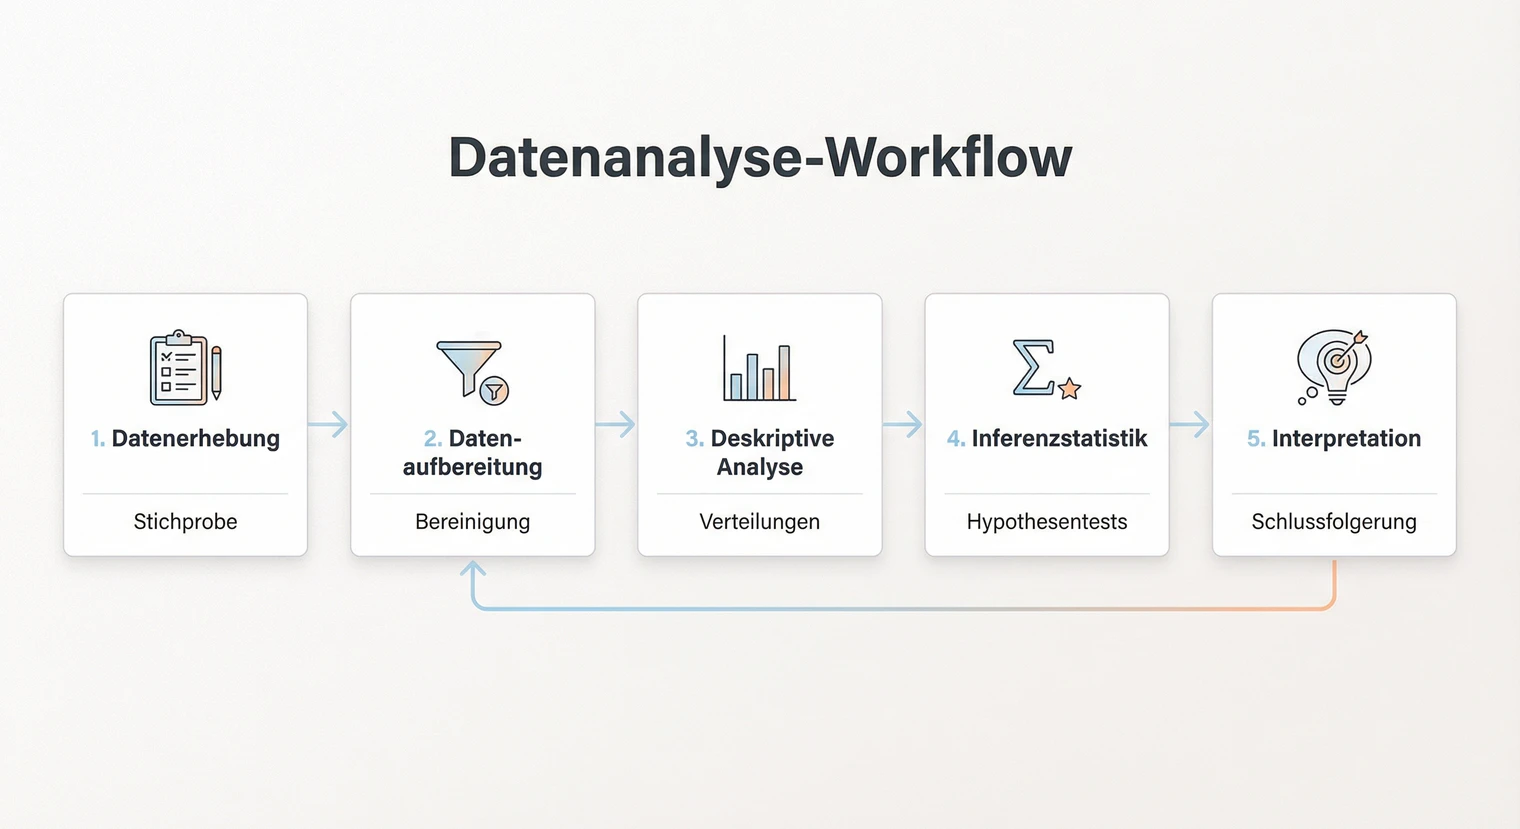
Ein hilfreicher Ausgangspunkt ist: Forschungsfrage und Analyseziel klären, Datenzugang oder Erhebung dokumentieren, Daten aufbereiten, das gewählte Verfahren anwenden und Ergebnisse im Kontext interpretieren. Bei Sekundärdaten prüfst du zunächst Herkunft, Erhebung und Eignung der vorhandenen Daten. Qualitative Verfahren haben eigene, oft wiederholte Analyseschritte; der folgende Ablauf beschreibt eine quantitative Auswertung.
-
Datenaufbereitung
Bei dieser quantitativen Auswertung beginnt die praktische Arbeit mit der Datenaufbereitung. Hier prüfst du deine Rohdaten auf Fehler, bereinigst sie und bringst sie in ein analysierbares Format. Dieser Schritt nimmt oft mehr Zeit in Anspruch als die eigentliche Auswertung, ist aber entscheidend für die Qualität deiner Ergebnisse.
-
Deskriptive Analyse
Danach folgt die deskriptive Analyse. Du beschreibst deine Daten mit Kennzahlen wie Mittelwert, Standardabweichung oder Häufigkeiten. So bekommst du einen ersten Überblick und erkennst Auffälligkeiten.
-
Inferenzstatistische Auswertung
Erst dann startest du mit der inferenzstatistischen Auswertung, bei der du Hypothesen testest und Zusammenhänge prüfst.
-
Interpretation
Zum Abschluss folgt die Interpretation: Du ordnest die Befunde in den Forschungskontext ein und leitest Schlussfolgerungen ab. Bei getrennten Ergebnis- und Diskussionskapiteln berichtest du die Befunde zunächst sachlich und interpretierst sie anschließend in der Diskussion. Auch bei einer integrierten Darstellung sollte erkennbar bleiben, was die Daten zeigen und wie du es deutest.
Datenaufbereitung: Der erste Schritt
Saubere Daten sind die Grundlage jeder Analyse. Die Datenaufbereitung ist kein glamouröser, aber ein unverzichtbarer Schritt. Fehler, die hier entstehen, ziehen sich durch die gesamte Auswertung.
Datenbereinigung und Ausreißer
Prüfe deine Daten auf Eingabefehler, unplausible Werte und Ausreißer. Ein Alter von 999 oder eine negative Zeitangabe sind offensichtliche Fehler. Ausreißer identifizieren: Boxplots zeigen Werte außerhalb der Whisker (1,5-facher Interquartilsabstand). Für spezifische Verfahren wie Regression gibt es zusätzliche Diagnostiken (siehe Abschnitt „Voraussetzungen prüfen“).
Umgang mit Ausreißern: Nicht automatisch löschen. Prüfe: Eingabefehler? Dann korrigieren oder auf fehlend setzen. Echter Extremfall? Dann: (1) Analyse mit und ohne Ausreißer durchführen, (2) Ergebnisse vergleichen, (3) beide berichten oder Entscheidung begründen.
Wichtig: Erstelle eine Kopie deiner Rohdaten, bevor du Änderungen vornimmst.
Fehlende Werte behandeln
Fehlende Werte (Missings) kommen in vielen Datensätzen vor. Dokumentiere zuerst Umfang, beobachtete Muster und bekannte Gründe. MCAR bedeutet, dass das Fehlen nicht von beobachteten oder fehlenden Werten abhängt. Bei MAR lässt es sich durch beobachtete Daten erklären; bei MNAR hängt es auch nach deren Berücksichtigung von fehlenden Werten ab. Das sind Annahmen über den Mechanismus, nicht bloß sichtbare Muster. Aus den beobachteten Daten allein lässt sich MAR nicht gegenüber MNAR bestätigen.
Wähle die Strategie passend zu Forschungsfrage, Analysemodell, Datenstruktur, Umfang und plausibler Mechanismusannahme. Ein vollständiger Fallausschluss kann Informationen verlieren und verzerren; eine kleine Prozentzahl macht ihn nicht automatisch geeignet. Multiple Imputation oder likelihood-basierte Verfahren können unter passenden Modellen und Annahmen sinnvoll sein. Pairwise deletion kann je nach Verfahren wechselnde Stichproben und schwer vergleichbare Schätzungen erzeugen.
Achtung: Jede Methode beruht auf Annahmen über fehlende und beobachtete Daten. Begründe diese Annahmen, nenne verwendete Hilfsvariablen und prüfe bei relevanter Unsicherheit in Sensitivitätsanalysen, ob alternative plausible Annahmen die Schlussfolgerung verändern.
Reporting-Checkliste fehlende Werte
Dokumentiere im Methodenteil:
- Umfang je Variable und beobachtete Muster über Variablen und Fälle
- bekannte Gründe für fehlende Werte
- angenommener Mechanismus und Begründung
- gewählte Methode einschließlich Imputations- oder Modellangaben
- analysierte Fallzahl je Hauptanalyse
- Ergebnisse relevanter Sensitivitätsanalysen
Fiktives Beispiel: „Die Rohdaten wurden auf Plausibilität geprüft. Bei der Bearbeitungszeit fehlten 4 von 200 Werten (2 %), weil ein zufälliger technischer Ausfall die Zeitmessung unterbrach. Für deren Mittelwert wurden die 196 vorhandenen Werte ausgewertet; andere Variablen waren vollständig. Der dokumentierte Ausfall wurde als unabhängig von den Messwerten eingeschätzt. Auffällige Werte wurden anhand von Boxplots und Erhebungsprotokollen geprüft. Da keine Eingabefehler erkennbar waren, wurden sie beibehalten.“ Ergänze für deine Analyse die tatsächlich gewählte Methode, ihre Annahmen und gegebenenfalls eine Sensitivitätsanalyse mit Ergebnis.
Software für die Datenanalyse
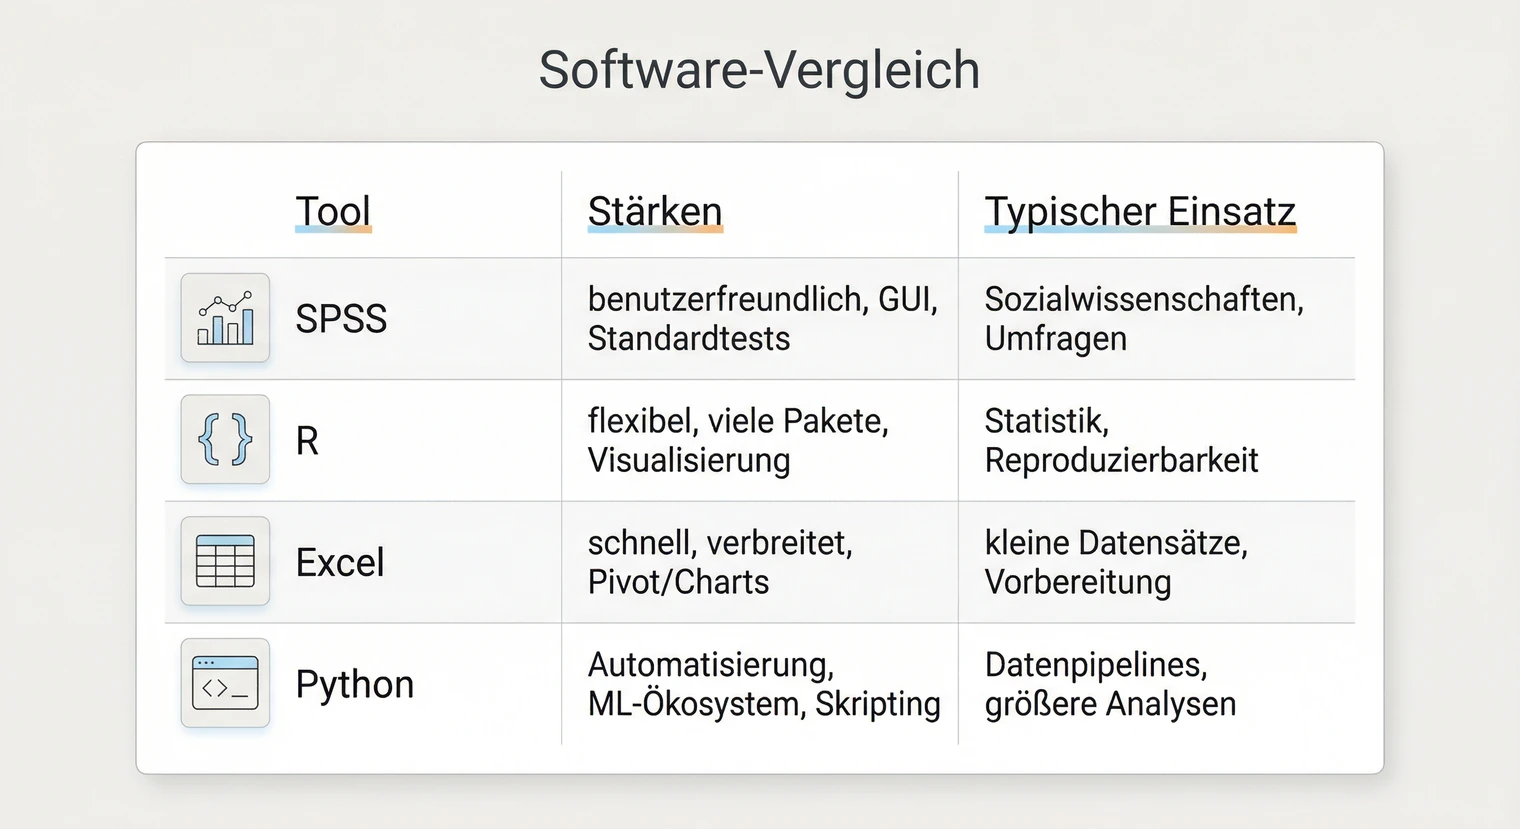
Die Wahl der Software hängt von deinen Vorkenntnissen, den Anforderungen deines Fachs und der Verfügbarkeit ab. Hier sind die gängigsten Tools mit ihren Stärken und Einsatzgebieten.
SPSS
Stärken: Intuitive Menüführung, etabliert in Sozial- und Wirtschaftswissenschaften. Die meisten Standardverfahren sind per Klick zugänglich. Syntax speicherbar für Reproduzierbarkeit.
Grenzen: Kostenpflichtig, weniger flexibel bei komplexen oder neuen Verfahren.
Gut für: Einsteigende, Umfrageauswertungen, klassische statistische Tests.
R
Stärken: Kostenlos, extrem flexibel, riesige Community. Reproduzierbare Analysen durch Skripte. Hervorragende Visualisierungen (ggplot2).
Grenzen: Steilere Lernkurve, erfordert Programmierbereitschaft.
Gut für: Fortgeschrittene Analysen, reproduzierbare Forschung, anspruchsvolle Visualisierungen.
Excel
Stärken: Dateneingabe, einfache deskriptive Statistik, Diagramme und Pivot-Tabellen. Der Analysis ToolPak der Desktop-Version unterstützt außerdem Verfahren wie lineare Regression.
Grenzen: Komplexe, wiederholbare Analyseabläufe, umfassende Diagnostik und spezialisierte Verfahren sind in Statistik- oder Skriptsoftware meist besser abbildbar. Manuelle Arbeitsschritte müssen besonders sorgfältig dokumentiert und geprüft werden.
Tipp: Nutze Excel nur, wenn es zu Verfahren, Datenumfang und Reproduzierbarkeitsanforderungen passt. Speichere Formeln, Bereinigungsschritte und Versionen nachvollziehbar.
Python
Stärken: Kostenlos, vielseitig (auch Machine Learning, Textanalyse). Für große Datensätze stehen spezialisierte Bibliotheken zur Verfügung; bei pandas hängen die Grenzen vom Arbeitsspeicher und den Analyseschritten ab.
Grenzen: Programmierung erforderlich, Statistik-Workflows weniger spezialisiert als in R.
Gut für: Interdisziplinäre Projekte, Automatisierung, Machine Learning.
Voraussetzungen prüfen
Jedes statistische Verfahren hat Annahmen. Wenn diese verletzt sind, können Ergebnisse irreführend sein. Hier sind die wichtigsten Checks mit konkreten Handlungsoptionen.
Normalverteilung
Prüfen: Kläre zuerst, welche Verteilung das konkrete Verfahren voraussetzt. Bei klassischen linearen Modellen und ANOVA betrifft die Normalitätsannahme die Fehler beziehungsweise Residuen, nicht pauschal jede Rohvariable. Beurteile Residuen mit Q-Q-Plot und weiteren zum Modell passenden Diagnostiken.
Zur „n > 30“-Faustregel: Eine feste Fallzahl garantiert keine Robustheit. Entscheidend sind Verfahren, Design, Gruppenungleichheit, Art der Abweichung und einflussreiche Beobachtungen.
Wenn verletzt: Prüfe zuerst Datenfehler und Modellspezifikation. Bei deutlicher Schiefe können eine fachlich sinnvolle Transformation oder ein geeignetes Modell helfen; Bootstrap- oder Rangverfahren müssen zu Zielgröße und Datenstruktur passen. Welch-Verfahren und heteroskedastizitätsrobuste Standardfehler behandeln vor allem ungleiche Varianzen, sie beheben keine beliebige Abweichung von der Normalverteilung.
Varianzhomogenität
Prüfen: Der Levene-Test prüft die Gleichheit der Gruppenvarianzen. Ein signifikantes Ergebnis, etwa p < .05 bei α = .05, spricht gegen diese Annahme. Ein nicht signifikantes Ergebnis beweist keine Varianzgleichheit. Beurteile zusätzlich Streuungen, Ausreißer und Gruppengrößen.
Wenn verletzt: Für Mittelwertsvergleiche unabhängiger Gruppen kommen der Welch-t-Test bei zwei Gruppen und die Welch-ANOVA bei mehreren Gruppen infrage. Games-Howell eignet sich für paarweise Vergleiche bei ungleichen Varianzen.
Regression: Zusätzliche Checks
Linearität und Modellspezifikation: Bei klassischer linearer Regression prüfst du Residuen gegen vorhergesagte Werte und relevante Prädiktoren. Erkennbare Struktur kann auf Nichtlinearität, ausgelassene Terme oder eine unpassende Modellform hinweisen.
Varianz und Abhängigkeit: Ein Trichtermuster kann auf Heteroskedastizität hinweisen. Je nach Design kommen eine andere Varianzstruktur, robuste Standardfehler oder ein anderes Modell infrage. Zeit-, Cluster- oder Messwiederholungsabhängigkeiten müssen im Modell berücksichtigt werden.
Multikollinearität: Nutze VIF, Toleranz und fachliche Plausibilität gemeinsam. Ein einzelner Grenzwert wie VIF > 10 ist kein automatisches Löschkriterium. Entferne oder kombiniere Variablen nur theorie- und analysebezogen.
Einflussreiche Fälle: Nutze Cook's Distance, Leverage und fallweise Änderungen als Screening. Eine gebräuchliche Orientierung für Cook's Distance ist 4/n, bei n = 200 also 0.02. Das ist keine Löschregel: Prüfe Datenfehler, fachliche Bedeutung und Modellpassung; dokumentiere begründete Sensitivitätsanalysen mit und ohne auffällige Fälle.
Statistische Verfahren auswählen
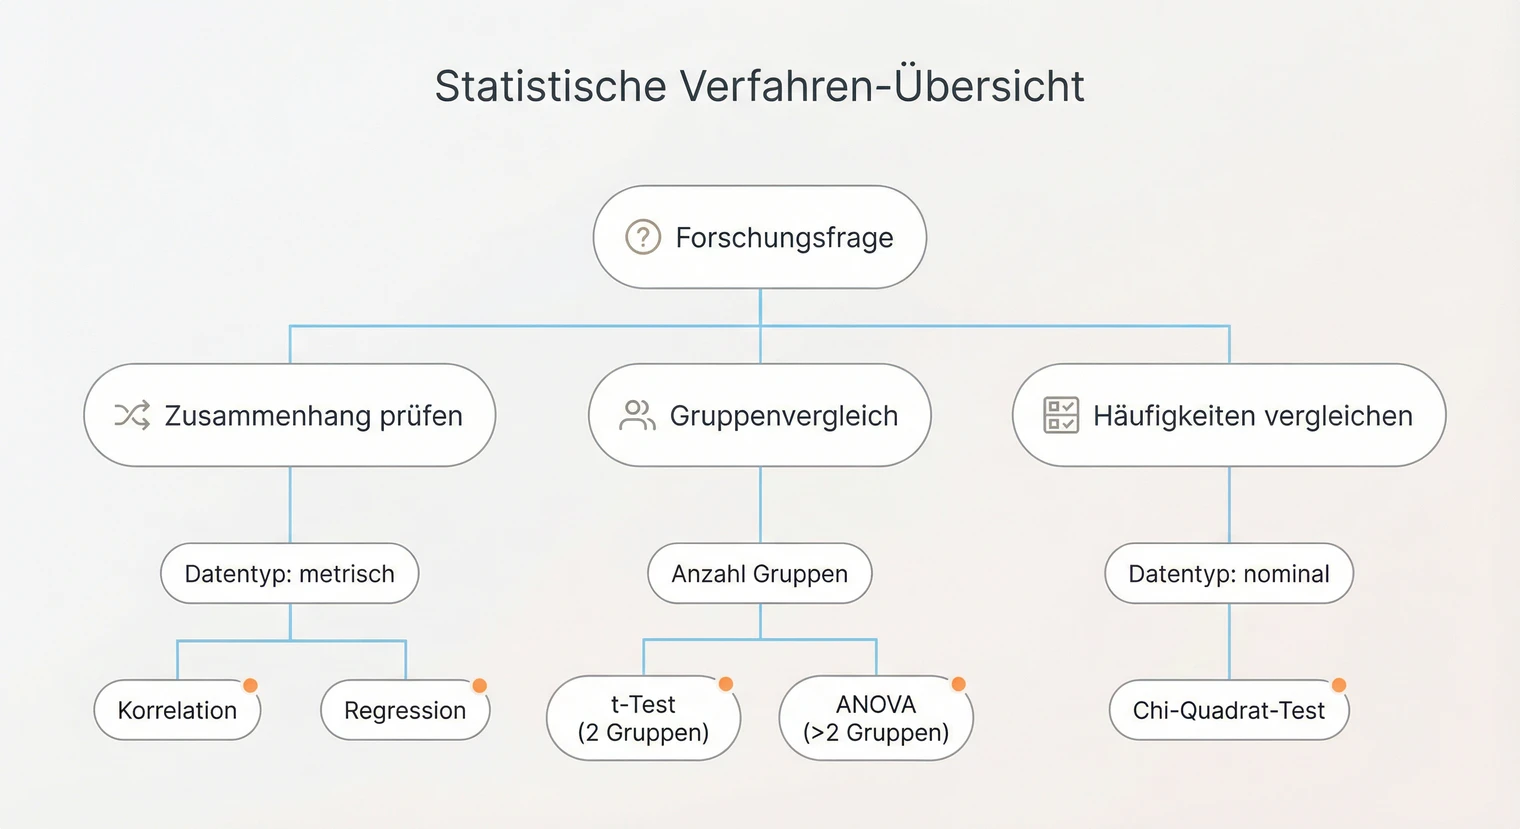
Das richtige Verfahren hängt von deiner Forschungsfrage, dem Skalenniveau und der Datenstruktur ab. Hier findest du eine Entscheidungshilfe für die gängigsten Situationen.
-
Zusammenhang zweier Variablen
Wähle die Kennzahl nach Ziel und Daten: Pearson für einen linearen Zusammenhang metrischer Variablen, Spearman für einen monotonen Rangzusammenhang. Prüfe Ausreißer, Form und Abhängigkeiten. Berichte Schätzung, Konfidenzintervall und gegebenenfalls p-Wert.
-
Zwei unabhängige Gruppen vergleichen
Wenn der Mittelwertsunterschied die Zielgröße ist, kommen je nach Varianzannahme Student- oder Welch-t-Test infrage. Der Mann-Whitney-U-Test vergleicht Verteilungen beziehungsweise Ränge und ist nicht automatisch ein Median-Test. Berichte eine zur Frage passende Effektgröße mit Intervall.
-
Mehr als zwei Gruppen vergleichen
Für Mittelwertsunterschiede kommen je nach Design und Varianzstruktur klassische oder Welch-ANOVA sowie geeignete Modelle infrage. Für einen Rangvergleich unabhängiger Gruppen kommt etwa Kruskal-Wallis infrage. Plane passende Kontraste oder Post-hoc-Vergleiche und berücksichtige Mehrfachtests; Rangverfahren beantworten andere Hypothesen. Bei Messwiederholung: Abhängigkeiten und Kovarianzstruktur im gewählten Modell berücksichtigen. Sphärizität ist nur für bestimmte univariate Messwiederholungs-ANOVAs relevant; Korrekturen oder alternative Modelle müssen zum Design passen.
-
Vorhersage / Einfluss (Regression)
AV metrisch: Ein lineares Modell kann passen, wenn Forschungsfrage, Funktionsform und Fehlerstruktur dazu passen. Berichte Koeffizienten mit Unsicherheit sowie Modellgüte und Diagnostik nach deinem Standard. AV binär: Eine logistische Regression kann passen. Berichte Koeffizienten oder Odds Ratios mit Konfidenzintervallen sowie festgelegte Maße zur Modellgüte.
-
Zusammenhang kategorialer Variablen
Bei unabhängigen Beobachtungen kann ein Chi-Quadrat-Test passen. Prüfe erwartete Zellhäufigkeiten; bei einer dünn besetzten 2×2-Tabelle kommt beispielsweise der exakte Fisher-Test infrage. Berichte beim Chi-Quadrat-Test etwa χ², Freiheitsgrade, p-Wert und Cramérs V. Beim exakten Fisher-Test entfallen χ² und Freiheitsgrade; für eine 2×2-Tabelle kannst du ein Odds Ratio mit Konfidenzintervall angeben.
Bei der Auswahl des Verfahrens gilt: Die Forschungsmethode bestimmt den Rahmen, die Datenstruktur die konkrete Analyse. Wenn du unsicher bist, prüfe die Voraussetzungen und konsultiere Methodenliteratur oder deine Betreuung.
Skalen und Messmodelle
In vielen Masterarbeiten werden Konstrukte mit mehreren Items gemessen, etwa Arbeitszufriedenheit oder Stresserleben. Dabei gibt es typische Stolperstellen, die du kennen solltest.
Likert-Skalen richtig verstehen
Einzelitem und Skala: Ein einzelnes Likert-Item mit geordneten Antwortkategorien ist ordinal. Ob und wie ein Wert aus mehreren Items als annähernd metrisch ausgewertet wird, hängt von Skalenkonstruktion, Analyseziel und begründeten Modellannahmen ab.
Skalenbildung: Folge dem Auswertungsschlüssel der verwendeten Skala. Lege fest, welche Items eingehen, wie invertierte Items codiert werden und wie viele beantwortete Items für Summe oder Mittelwert nötig sind.
Invertierte Items: Bei einer Skala mit beliebigem Minimum und Maximum gilt: neuer Wert = Minimum + Maximum - alter Wert. Für eine Skala von 1 bis 5 wird daraus 6 - alter Wert. Prüfe die Codierung anschließend an einigen Fällen.
Reliabilität prüfen
Cronbachs Alpha: Alpha beschreibt die interne Konsistenz von Skalenwerten und hängt unter anderem von Itemzahl und Itemzusammenhängen ab. .70 ist eine verbreitete Orientierung in den Sozialwissenschaften, keine allgemeine Bestehensgrenze. Alpha beweist weder Eindimensionalität noch Validität. Bei einem sehr hohen Alpha, etwa .96, prüfe zusätzlich, ob Items inhaltlich redundant sind.
Berichten: „Für die Skala [Name] mit [k] Items betrug Cronbachs Alpha α = .XX.“ Begründe, warum Alpha für die Skala geeignet ist, und verweise bei etablierten Skalen auf Quelle, Auswertungsschlüssel und frühere Gütebefunde.
Tipp: Nutze Item-Statistiken und „Alpha wenn Item gelöscht“ zur Diagnose, nicht als automatische Löschregel. Prüfe bei Auffälligkeiten Codierung, Dimensionalität und inhaltliche Abdeckung; begründe jede Änderung an einer etablierten Skala.
Qualitative Datenanalyse
Bei qualitativen Daten wie Interviewtranskripten, Beobachtungsprotokollen oder Dokumenten hängen Ablauf und Qualitätskriterien vom gewählten Ansatz ab. Lege Erkenntnisziel, methodologische Position und Auswertungsverfahren offen und verwende dazu passende Begriffe und Arbeitsschritte.
Vorgehen: Du entwickelst ein Kategoriensystem (deduktiv aus Theorie oder induktiv aus dem Material), ordnest Textstellen Kategorien zu (Codieren) und verdichtest diese zu Ergebnissen.
Codebuch: Definiere je nach Ansatz Kategorien, Regeln, Ankerbeispiele und Abgrenzungen. Ob das vollständige Codebuch in den Anhang, in Zusatzmaterial oder nur auszugsweise in den Methodenteil gehört, bestimmen Leitfaden, Umfang und Vertraulichkeit.
Codebuch-Beispiel (Auszug)
| Kategorie | Definition | Ankerbeispiel | Abgrenzung |
|---|---|---|---|
| Arbeitszufriedenheit | Positive oder negative Bewertung der eigenen Arbeitssituation. | „Im Großen und Ganzen bin ich zufrieden mit meinem Job.“ | Nicht: Reine Tätigkeitsbeschreibungen ohne Bewertung. |
| Work-Life-Balance | Aussagen zur Vereinbarkeit von Beruf und Privatleben. | „Ich schaffe es kaum, Zeit für die Familie zu haben.“ | Nicht: Aussagen zu Arbeitszeiten ohne Bezug zum Privatleben. |
-
Arbeitszufriedenheit
Definition
Positive oder negative Bewertung der eigenen Arbeitssituation.
Ankerbeispiel
„Im Großen und Ganzen bin ich zufrieden mit meinem Job.“
Abgrenzung
Nicht: Reine Tätigkeitsbeschreibungen ohne Bewertung.
-
Work-Life-Balance
Definition
Aussagen zur Vereinbarkeit von Beruf und Privatleben.
Ankerbeispiel
„Ich schaffe es kaum, Zeit für die Familie zu haben.“
Abgrenzung
Nicht: Aussagen zu Arbeitszeiten ohne Bezug zum Privatleben.
Transparenz: Dokumentiere Sampling, Erhebung, Analyseschritte, Änderungen am Kategoriensystem und deine Rolle im Interpretationsprozess so, dass die Vorgehensweise nachvollziehbar ist.
Zusammenarbeit beim Codieren: Ob unabhängige Zweitcodierung, Konsensgespräche oder reflexive Teamarbeit sinnvoll sind, hängt vom Ansatz ab. Bei reflexiver thematischer Analyse ist Intercoder-Reliabilität beispielsweise keine allgemeine Qualitätsanforderung.
Revisionsrunde: Prüfe Kategorien, Interpretationen und Gegenbeispiele im Verlauf. Halte fest, was geändert wurde und warum.
Ergebnisse darstellen und berichten
Die Darstellung deiner Ergebnisse sollte klar, präzise und nachvollziehbar sein. Die folgenden Formulierungsbausteine zeigen typische Berichtsformen. Das ausgefüllte t-Test-Beispiel ist fiktiv; ersetze Zahlen und Platzhalter durch deine Ergebnisse und passe Kennwerte, Korrekturen und Wortwahl an deine Analyse an.
M = Mittelwert, SD = Standardabweichung, n = Stichprobengröße, df = Freiheitsgrade, p = p-Wert.
CI = Konfidenzintervall, SE = Standardfehler, AV/UV = Abhängige/Unabhängige Variable.
β/B = Regressionsgewichte, R² = erklärte Varianz, α = Cronbachs Alpha oder Signifikanzniveau.
Formate können je nach Fach (z. B. APA) leicht variieren. Folge im Zweifel den Vorgaben deiner Betreuung.
t-Test
Fiktives Beispiel für zwei unabhängige Gruppen mit angenommener Varianzgleichheit: „In der Trainingsgruppe (n = 40) betrug der Testwert M = 80.00 (SD = 10.00), in der Kontrollgruppe (n = 40) M = 75.00 (SD = 10.00). Der geschätzte Mittelwertsunterschied betrug 5.00 Punkte, 95 % CI [0.55, 9.45], t(78) = 2.24, p = .028, Cohens d = 0.50 (mit gepoolter Standardabweichung).“
ANOVA
„Für den Faktor [Name] ergab sich F(df1, df2) = X.XX, p = .XXX, partielles η² = .XX. Der Vergleich zwischen Gruppe A und B ergab einen Mittelwertsunterschied von X.XX Punkten (95 % CI [X.XX, X.XX]; nach Holm korrigiertes p = .XXX).“ Gib an, ob das Intervall ebenfalls korrigiert ist.
Bei univariater Messwiederholungs-ANOVA: „Wegen einer Verletzung der Sphärizitätsannahme wurde eine Greenhouse-Geisser-Korrektur verwendet (ε = .XX). Für den Zeiteffekt ergab sich F(df1_korr, df2_korr) = X.XX, p = .XXX, partielles η² = .XX.“ Ergänze die Diagnostik und verwende die tatsächlich gewählte Korrektur.
Korrelation / Regression
„Zwischen [V1] und [V2] betrug die Pearson-Korrelation r = .XX, 95 % CI [X.XX, X.XX], p = .XXX.“ Bei einer Spearman-Analyse benennst du stattdessen die Rangkorrelation r_s und das verwendete Intervallverfahren.
„Das lineare Regressionsmodell erklärte R² = .XX der beobachteten Varianz, F(df1, df2) = X.XX, p = .XXX. Für [Prädiktor] betrug der geschätzte Koeffizient B = X.XX, SE = X.XX, 95 % CI [X.XX, X.XX], p = .XXX.“
Chi-Quadrat
„Für [V1] und [V2] ergab sich χ²(df, N = XXX) = X.XX, p = .XXX, Cramérs V = .XX.“ Dokumentiere außerdem die unabhängigen Beobachtungen und die Prüfung der erwarteten Zellhäufigkeiten.
Fehlen fachliche Vergleichswerte, können Cohens Konventionen eine erste Orientierung bieten: Für den Betrag von d stehen 0.2, 0.5 und 0.8 für kleine, mittlere und große Effekte; für den Betrag von r sind es .10, .30 und .50. Für η² werden .01, .06 und .14 genannt. Übertrage diese η²-Werte nicht ungeprüft auf partielles η² bei Messwiederholungen oder Modellen mit Kovariaten. Benenne die Effektgröße eindeutig und berichte nach Möglichkeit ein Konfidenzintervall.
Wichtig: Konventionelle Bezeichnungen wie „klein“, „mittel“ oder „groß“ sind höchstens Ausgangspunkte. Ordne den Wert anhand fachlicher Vergleichswerte, Messskala, Unsicherheit und praktischer Bedeutung ein.
Auch diese Formulierungen sind anzupassen. Häufigkeitsangaben passen nur, wenn Zählen im gewählten Ansatz analytisch sinnvoll ist.
Fiktives Beispiel einer Inhaltsanalyse: „Die Kategorie Work-Life-Balance zeigt, dass Zeitkonflikte zwischen Beruf und Familie den Alltag prägen. Acht von zehn Befragten beschrieben solche Konflikte.“ Die Zahl beschreibt das untersuchte Material, nicht die Häufigkeit in der Bevölkerung.
„Exemplarisch zeigt sich dies in der Aussage von Person A: ‚[Zitat]‘ (Interview A, Z. 45 bis 48).“
„Abweichend davon äußerte Person C eine gegenteilige Einschätzung: ‚[Zitat]‘ (Interview C, Z. 78).“
Tipp: Wähle Zitate, die die analytische Aussage tragen, und zeige auch Abweichungen. Kürze mit [...] ohne Sinnveränderung; verwende die in deinem Leitfaden verlangte Fundstelle.
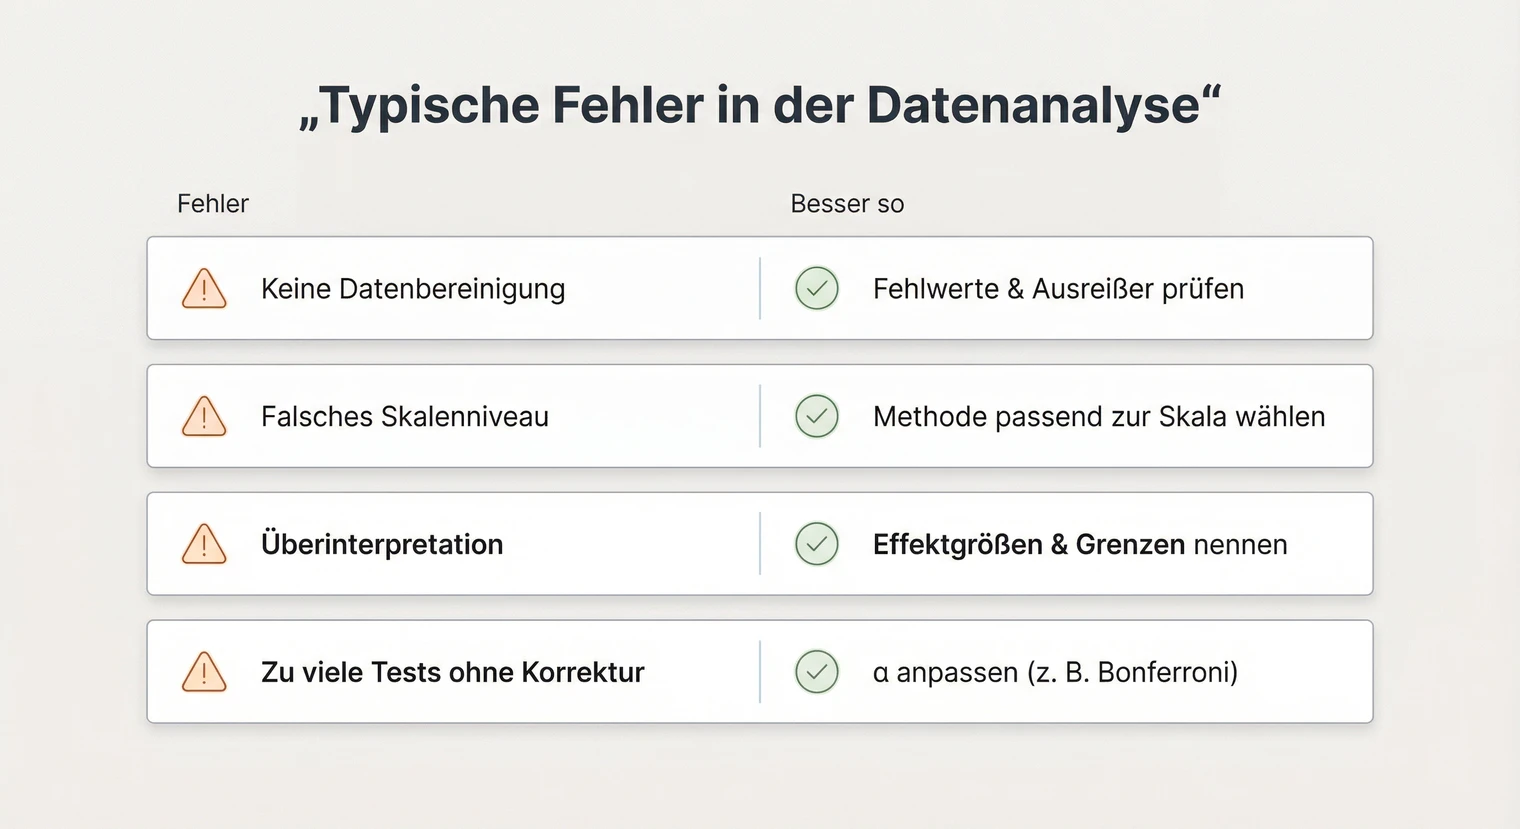
Typische Fehler und Analyse-Fallen
Bei der Datenanalyse passieren einige Fehler immer wieder. Hier sind die häufigsten mit konkreten Gegenmaßnahmen.
-
Datenaufbereitung vernachlässigen
Problem: Wer direkt mit der Analyse startet, übersieht oft Fehler in den Daten.
So behebst du es: Nimm dir Zeit für die Datenprüfung. Kontrolliere Häufigkeiten, Minima und Maxima aller Variablen.
-
Voraussetzungen nicht prüfen
Problem: Jedes Verfahren hat Annahmen. Wenn diese verletzt sind, können Ergebnisse irreführend sein.
So behebst du es: Siehe Abschnitt „Voraussetzungen prüfen“ oben. Dokumentiere die Prüfung im Methodenteil.
-
Kausalitätsfehlschluss
Problem: Korrelation zeigt Zusammenhang, nicht Ursache.
So behebst du es: Formuliere vorsichtig („steht im Zusammenhang mit“), statt Ursache-Wirkung zu behaupten.
-
Overfitting
Problem: Zu viele Prädiktoren bei kleiner Stichprobe können zu instabilen Modellen führen.
So behebst du es: Leite Modellkomplexität und Stichprobengröße aus Design, erwarteter Signalstärke, Ereignisverteilung und geeigneter Validierung ab; eine starre Zahl pro Prädiktor reicht dafür nicht.
-
Unzureichende Fallzahl
Problem: Eine geringe Fallzahl kann Schätzungen unpräzise und Analysen wenig aussagekräftig machen.
So behebst du es: Begründe die Fallzahl passend zum Design und berichte Schätzungen mit Unsicherheitsintervallen. Interpretiere breite Intervalle und instabile Ergebnisse zurückhaltend.
Multiple Tests und selektives Berichten: Lege primäre und sekundäre Analysen möglichst vor Einsicht in die Ergebnisse fest und kennzeichne explorative Analysen. Definiere bei mehreren inferenzstatistischen Vergleichen die relevante Testfamilie und verwende ein zum Ziel passendes Verfahren zur Kontrolle der Fehlerrate, etwa Holm, Bonferroni oder eine FDR-Methode. Berichte alle durchgeführten Analysen und Korrekturen nachvollziehbar.
Nächste Schritte
Wenn du deine Datenanalyse abgeschlossen hast, folgen die letzten Schritte auf dem Weg zur Abgabe.
Ergebnisse in die Arbeit integrieren: Strukturiere nach Forschungsfragen oder Hypothesen und verweise auf Tabellen und Abbildungen. Trenne Darstellung und Interpretation so, wie es dein Leitfaden vorsieht; manche Arbeiten nutzen getrennte Kapitel, andere eine integrierte Ergebnisdiskussion.
Diskussion schreiben: Ordne deine Ergebnisse in den Forschungskontext ein. Was bedeuten sie für die Theorie? Welche praktischen Implikationen gibt es? Benenne Limitationen und Ansatzpunkte für zukünftige Forschung.
-
Reproduzierbarkeit: Syntax/Skripte gespeichert, Analyseschritte dokumentiert, Rohdaten gesichert.
-
Reporting vollständig: Analysierte Fallzahl, Schätzungen, Unsicherheitsintervalle, verfahrensspezifische Testangaben, Effektgrößen und Diagnostik nach Leitfaden geprüft.
-
Tabellen & Grafiken: Einheitliche Formatierung, klare Beschriftung und korrekte Verweise im Text.
-
Voraussetzungen: Prüfung im Methodenteil dokumentiert, Umgang mit Verletzungen begründet.
-
Anhang und Zusatzmaterial: Prüfe nach Leitfaden, ob Fragebogen, Codebuch, ergänzende Tabellen oder Analysesyntax beigefügt werden sollen und ob Datenschutz oder Vertraulichkeit Grenzen setzen.
Vor der Abgabe steht die Plagiatsprüfung. Auch bei der Datenanalyse gilt: Übernommene Methoden oder Analysestrategien aus anderen Arbeiten solltest du korrekt kennzeichnen und zitieren.
Möchtest du deine Masterarbeit drucken und binden lassen, konfigurierst du das bei BachelorHero online. So hast du am Ende ein professionell gebundenes Exemplar für die Abgabe.
Häufig gestellte Fragen
Wie strukturiere ich den Ergebnisteil meiner Masterarbeit?
Gliedere nach Forschungsfragen oder Hypothesen. Zeige pro Abschnitt zuerst deskriptive Befunde, etwa M, SD und n, danach passende Schätzungen, Konfidenzintervalle und Tests. Benenne den Befund kurz und verweise auf Tabellen oder Abbildungen. Bei getrennten Kapiteln folgt die Interpretation in der Diskussion; besonders qualitative Arbeiten können Ergebnisse und Diskussion auch verbinden. Richte die Kapitelstruktur nach deinem Fachleitfaden aus.
Welche Kennwerte muss ich in Tabellen angeben?
Nenne die analysierte Fallzahl und passende deskriptive Kennwerte, etwa M und SD oder Median und Quartile. Bei Tests gehören die verfahrensspezifische Teststatistik, gegebenenfalls Freiheitsgrade, p-Wert sowie passende Effektgrößen und Konfidenzintervalle dazu. Bei linearer Regression sind B, SE oder Konfidenzintervalle, gegebenenfalls β und R² typische Angaben. Bei logistischer Regression sind Odds Ratios mit Konfidenzintervallen hilfreich; benenne verwendete Maße wie Pseudo-R² genau. Beschrifte Tabellen eindeutig, erkläre Abkürzungen und ergänze relevante Modelldiagnostik nach Berichtsstandard.
Was mache ich, wenn meine Daten nicht normalverteilt sind?
Prüfe nicht pauschal die Verteilung aller Rohwerte. Welche Annahme relevant ist, hängt vom Verfahren ab; bei klassischen linearen Modellen betreffen Normalität und konstante Varianz die Fehler beziehungsweise Residuen. Beurteile Residuenplots, Ausreißer, Design und Stichprobengröße gemeinsam. Welch-Verfahren können bei ungleichen Varianzen sinnvoll sein. Rangverfahren beantworten teilweise andere Fragen: Der Mann-Whitney-U-Test ist nicht automatisch ein Test auf Medianunterschiede. Wähle eine Alternative deshalb nach Zielgröße und Annahmen und kennzeichne Sensitivitätsanalysen als solche.
Wie begründe ich meine Testwahl im Methodenteil?
Nenne (1) Forschungsfrage und Zielgröße, (2) Datenstruktur und Design, (3) das gewählte Modell oder Verfahren und (4) die dafür relevanten Annahmen und Diagnostiken. Begründe außerdem den Umgang mit Verletzungen, Ausreißern, fehlenden Werten und Mehrfachtests. Ein einzelner Vorabtest, etwa Levene, ersetzt diese Begründung nicht.
Wie viele Daten brauche ich für eine statistische Auswertung?
Die nötige Stichprobengröße hängt stark von mehreren Faktoren ab: erwartete Effektgröße (kleine Effekte brauchen mehr Fälle), Varianz in den Daten, Anzahl der Prädiktoren, Design (Cluster, Messwiederholung) und Dropout/Missings. Zahlen wie „30 pro Gruppe“ oder „10 Fälle pro Prädiktor“ sind sehr grobe, unsichere Daumenregeln, keine Mindestanforderungen. Eine Power-Analyse (z. B. G*Power) hilft bei der Planung. Besprich das frühzeitig mit deiner Betreuung.
Wann nutze ich parametrische und wann nicht-parametrische Tests?
Die Unterscheidung ist keine automatische Entscheidung zwischen zwei Testlisten. Parametrische Verfahren modellieren bestimmte Parameter und Verteilungen; rangbasierte Verfahren können andere Hypothesen beantworten. Prüfe Forschungsfrage, Zielgröße, Abhängigkeiten, Skalenniveau und verfahrensspezifische Annahmen. Bei ungleichen Varianzen kann etwa ein Welch-Verfahren passen; bei einer rangbasierten Analyse muss die Interpretation zum gewählten Test passen.
Wie gehe ich mit fehlenden Werten um?
Dokumentiere Umfang je Variable, beobachtete Muster über Variablen und Fälle sowie bekannte Gründe. MCAR, MAR und MNAR sind Annahmen über den Mechanismus; MAR lässt sich aus den beobachteten Daten nicht gegen MNAR bestätigen. Wähle Fallausschluss, multiple Imputation oder ein likelihood-basiertes Verfahren passend zu Analysemodell und plausiblen Annahmen, nicht nach einer festen Prozentgrenze. Berichte die Fallzahl je Analyse und prüfe bei relevanter Unsicherheit alternative plausible Annahmen in einer Sensitivitätsanalyse.
Wie interpretiere ich einen p-Wert richtig?
Der p-Wert ist unter der Nullhypothese und den übrigen Modellannahmen die Wahrscheinlichkeit einer mindestens so extremen Teststatistik wie der beobachteten. Er ist weder die Wahrscheinlichkeit, dass die Nullhypothese wahr ist, noch ein Maß für Effektgröße oder praktische Bedeutung. Berichte Schätzung, Unsicherheit und Kontext und stütze die Schlussfolgerung nicht allein auf eine Schwelle wie .05.

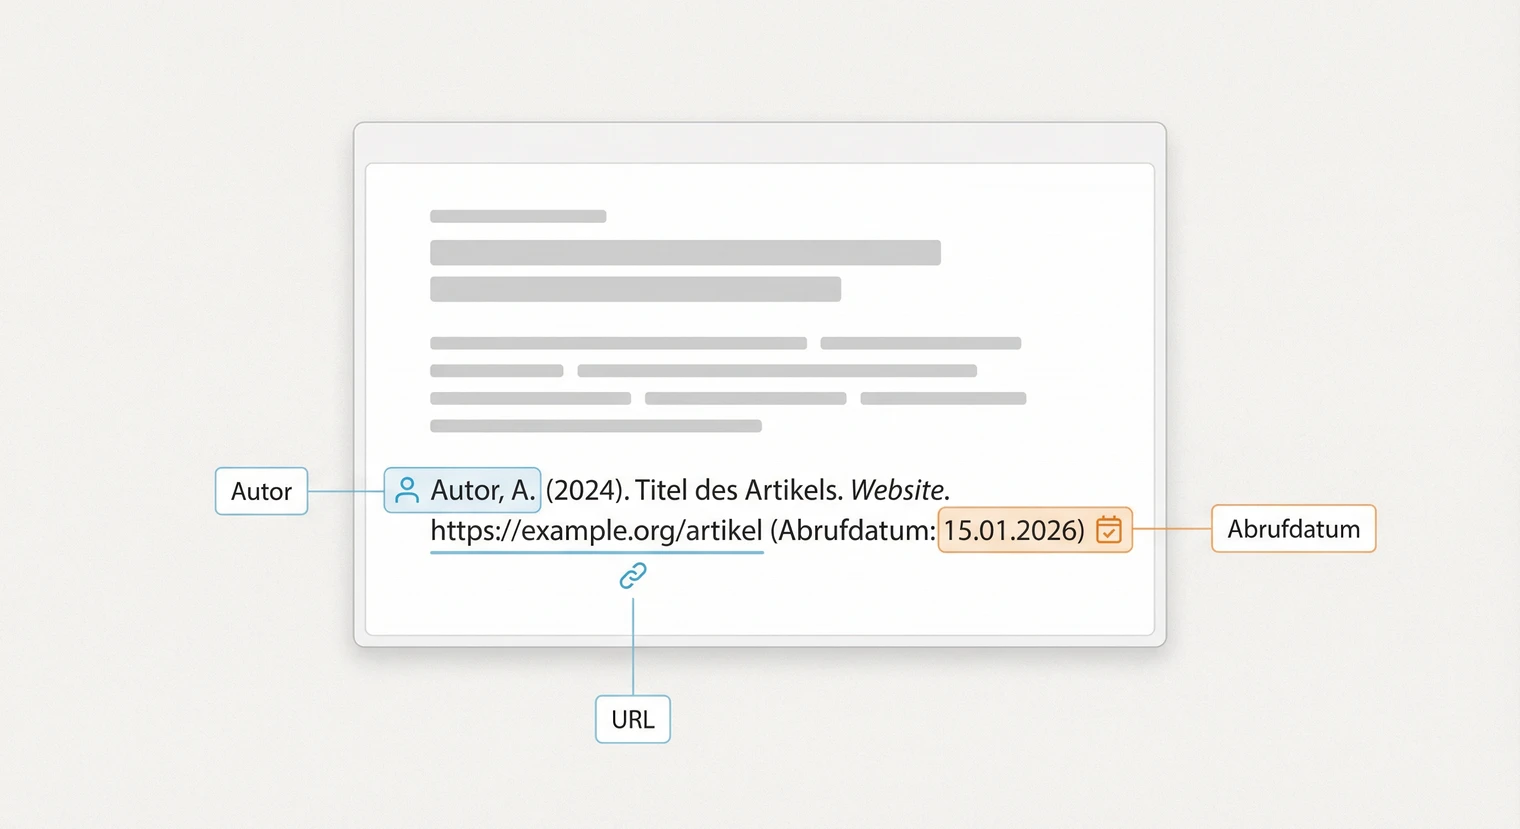 Internetquellen richtig zitieren
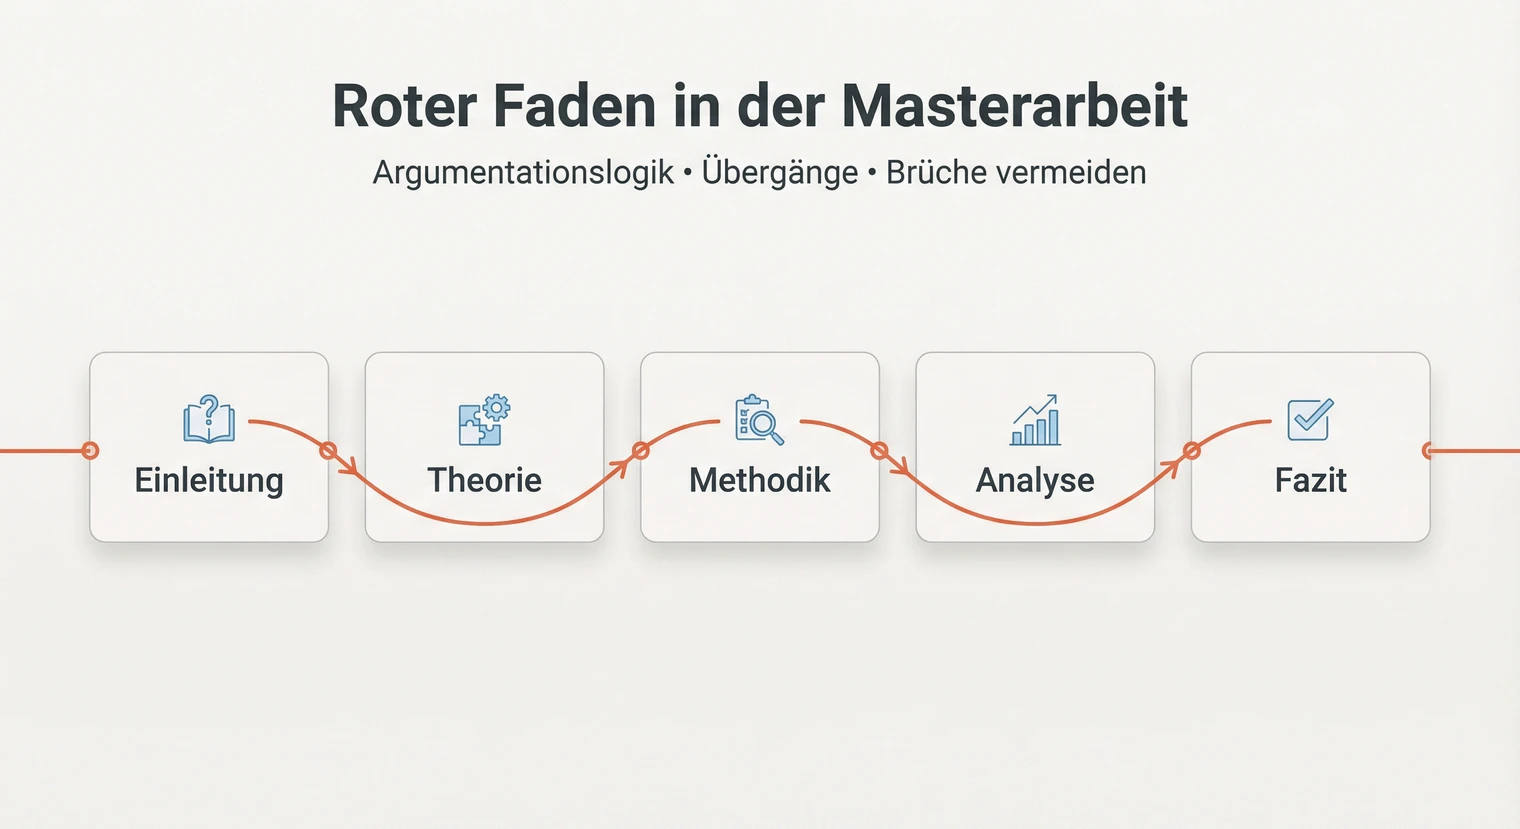 Roter Faden in der Masterarbeit
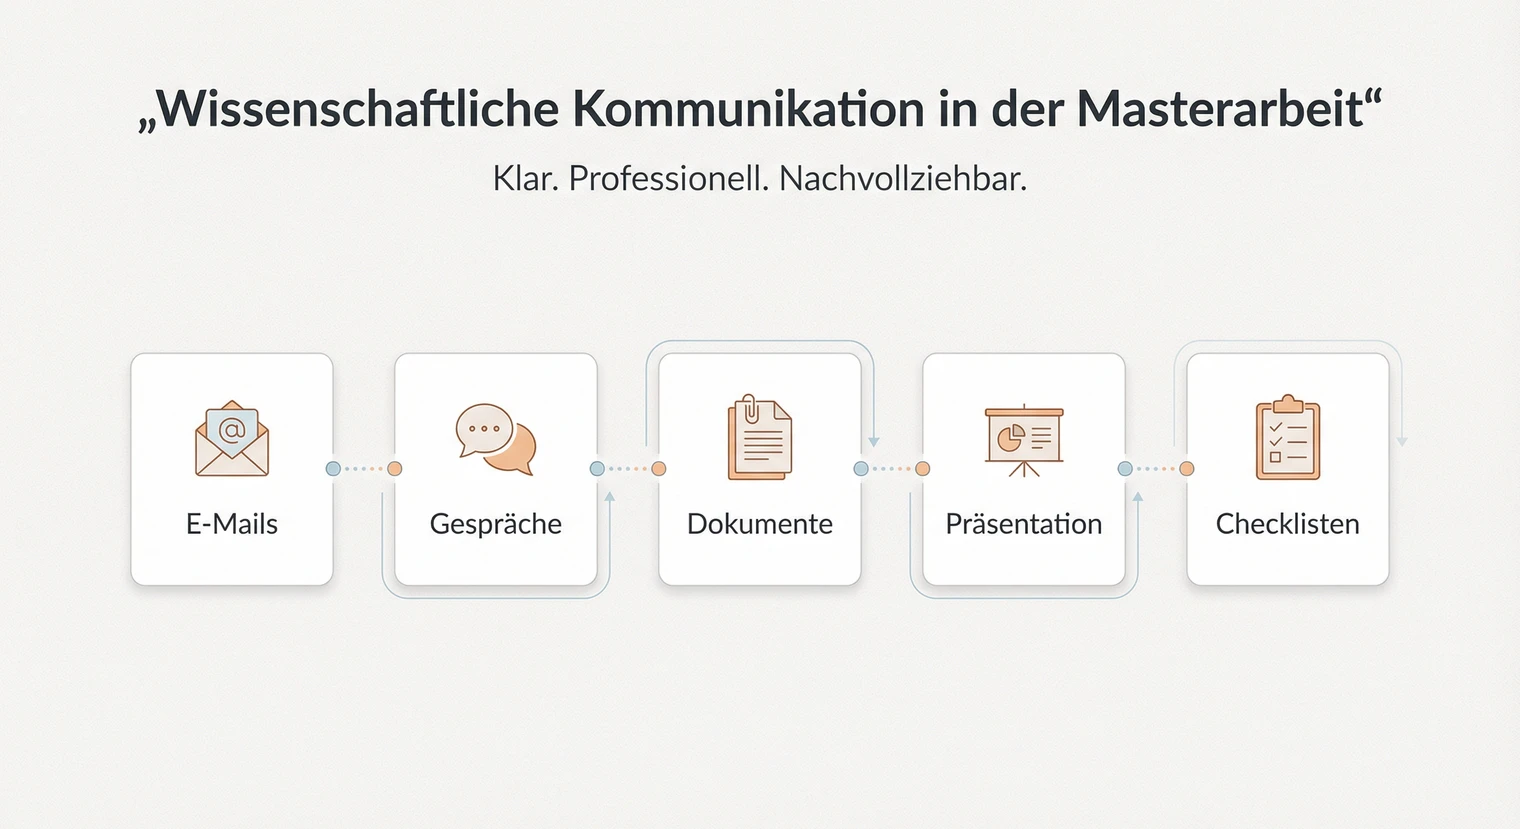 Wissenschaftliche Kommunikation